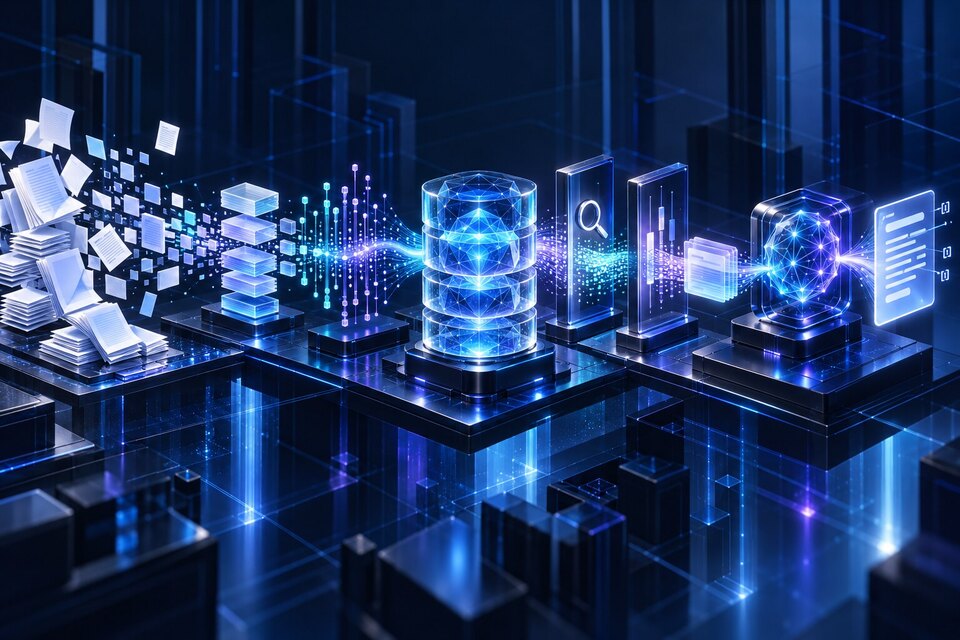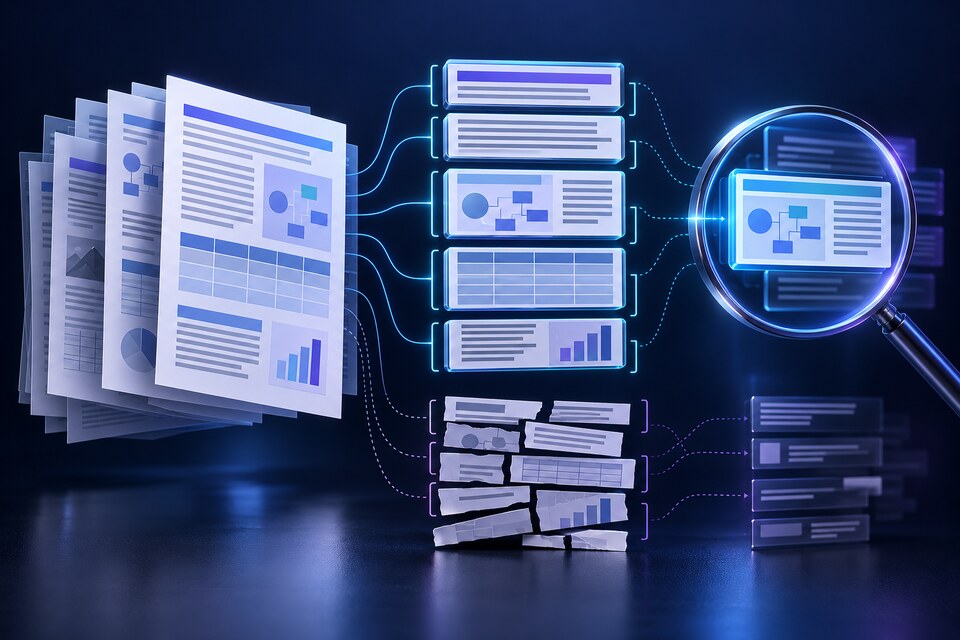
تبدأ استراتيجية تقسيم PDF الموثوقة من بنية المستند، لا من رقم ثابت للتوكنز. استخرج العناوين والفقرات والقوائم والجداول والرسوم وإحداثيات الصفحة كعناصر محددة النوع، ثم أنشئ مقاطع أبناء قابلة للاسترجاع داخل هذه الحدود، واحتفظ بعلاقة المقطع بالأب والقسم والصفحة، وبعدها اختبر هل يظهر الدليل المطلوب عند طرح أسئلة واقعية. يهم ذلك في أدلة السياسات والعقود والتقارير والمواصفات؛ لأن النافذة الثابتة قد تفصل الاستثناء عن قاعدته أوتفصل قيمة الجدول عن رأس العمود. هذا مناسب لمهندسي RAG الإنتاجي، وليس للبيانات التي يجب قراءتها مباشرة من SQL أوAPI.
تم التحقق من الوثائق المرجعية في 6 أكتوبر 2026. السلوك الموثق للأدوات والمحللات منفصل أدناه عن التوصيات الهندسية الخاصة بالتخزين وتوسيع النتائج والتقييم.
صنّف المستند قبل اختيار أداة التقسيم
لا تمرر كل ملف إلى Recursive Splitter واحد. ملف PDF مولود رقميًا وله عناوين واضحة، وفاتورة ممسوحة، وبحث ذو عمودين، وتقرير مالي بجداول تعبر الصفحات هي مدخلات مختلفة. ابدأ بتحديد هل النص قابل للتحديد، وهل يحتاج OCR، وهل ترتيب القراءة صحيح، وهل الجداول تحمل حقائق أساسية، وهل المستند سردي أو مرجعي أو يحتوي بيانات معاملات.
في Markdown أوHTML النظيف يمكن للتقسيم حسب العناوين حفظ الهرمية. توثق LangChain أن مقسم Markdown يجمع المحتوى وفق العناوين المحددة ويحفظها في Metadata، ثم يمكن تشغيل مقسم حجمي داخل كل مجموعة. أما PDF فيجب استعادة الهرمية من التخطيط أولًا. إذا كان ترتيب القراءة خاطئًا فلن يصلحه ضبط حجم المقطع.
استخرج التخطيط إلى عناصر محددة النوع قبل التقسيم
تفرق وثائق Unstructured بين Partitioning وChunking. يكتشف التقسيم الأول عناصر دلالية مثل العناوين والنص السردي والجداول. بعد ذلك يجمع Chunking العناصر الكاملة المتتابعة، ولا يلجأ إلى قطع النص إلا عندما يتجاوز عنصر واحد الحد الأقصى. هذا مختلف جذريًا عن تسطيح PDF إلى نص ثم القطع كل عدد ثابت من الحروف.
وبالمثل تستخرج Document Layout skill في Azure بنية المستند، ويمكنها إخراج أقسام Markdown مع هرمية العناوين أوأقسام نصية مع موقع الصفحة. تدعم صيغًا مكتبية وصورًا شائعة، لكن الوثائق تنبه إلى اختلاف سلوك الصور بين الصيغ وإمكان انتهاء مهلة معالجة المستند الطويل. عامل اختيار Parser وجودة OCR كمراحل قابلة للمراقبة والفشل المستقل.
ابنِ نموذج عناصر دلالية بسلالة ثابتة
خزّن تسلسل العناصر المستخرجة قبل إنشاء Embeddings. يحتاج كل عنصر إلى إصدار مستند ثابت، وترتيب، ونوع، ورقم صفحة، وإحداثيات عند توفرها، ومسار قسم، ومؤشر إلى الملف الأصلي. احتفظ بمعرفات العناصر الأصلية حتى تستطيع إعادة بناء المقاطع بعد تغيير الحجم أونموذج التضمين دون إعادة OCR مكلف بلا حاجة.
افصل بين هوية المحتوى وهوية المتجه:
{
  "document_version": "manual:v17",
  "element_ids": ["e_184", "e_185"],
  "section_path": ["الإرجاع", "المنتجات التالفة"],
  "pages": [12, 13],
  "chunk_kind": "narrative",
  "chunk_hash": "sha256:...",
  "embedding_version": "embed-v4"
}
هذا مخطط للتطبيق وليس عقدًا لمزود. يجعل الاستشهادات وإعادة الفهرسة والحذف والتقييم تشير إلى الدليل نفسه حتى بعد إعادة توليد المتجهات.
احفظ مسار العناوين مع كل مقطع ابن
يصعب استرجاع فقرة تقول «يطبق هذا الاستثناء لمدة 30 يومًا» إذا كان اسم المنتج والسياسة والقسم موجودًا قبل صفحات. احفظ مسار العنوان في Metadata، وغالبًا أضف صيغة مختصرة منه إلى النص المضمّن. توثق LangChain حفظ معلومات العنوان عند ضبط الحجم داخل المجموعة، بينما تغلق استراتيجية `by_title` في Unstructured المقطع عند بدء عنوان جديد.
لا تثق آليًا بكل عنوان مكتشف. قد يصنف OCR نقطة قصيرة أوLabel زخرفيًا كعنوان. أضف تحققًا للقفزات غير المنطقية في الهرمية، وRunning Headers المتكررة، والأقسام ذات الأحرف القليلة. احتفظ بالنص الخام والعنوان الموحّد وإشارة ثقة حتى تدخل الملفات منخفضة الثقة إلى المراجعة بدل إنتاج مئات المقاطع الصغيرة بصمت.
تعامل مع الجدول كدليل منظم لا كفقرة
توثق Unstructured أن عنصر `Table` يُعزل ولا يُدمج مع النص المحيط، وهو افتراضي جيد لأن للجدول Schema خاصًا. احفظ العنوان ورؤوس الأعمدة والصفوف والحواشي ونطاق الصفحات ومسار القسم. خزّن تمثيلًا مقروءًا للاسترجاع، لكن احتفظ بالخلايا المحللة منفصلة حتى تتحقق طبقة الإجابة من القيم الدقيقة.
للجدول المرجعي الصغير قد يكفي Markdown أوHTML مكتفٍ بذاته. أما الجدول العريض أوالعابر للصفحات فأنشئ مجموعات صفوف تكرر الرؤوس اللازمة وتحمل Parent Table ID. لا تضمّن قيمة مثل «12.4%» دون المقياس والفترة والجهة التي تعطيها معناها. وإذا احتاج المستخدم تجميعًا أوفلترة أوأحدث رصيد عبر صفوف كثيرة، فانقل البيانات إلى SQL أوAnalytical Store واستدعِ Query موثوقًا بدل مطالبة Semantic Retrieval بالحساب من نص مسطح.
استخدم مقاطع الأب والابن للأقسام الطويلة
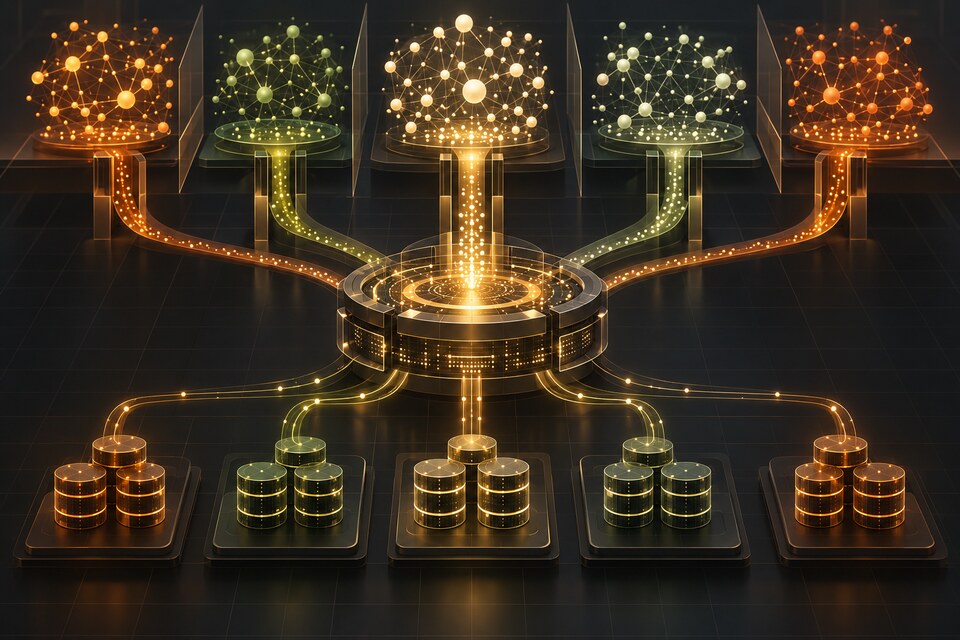
المقطع الابن الصغير أسهل في الاسترجاع الدقيق، بينما قد يكون قسم الأب الأكبر أفضل كدليل للتوليد. خزّن الهويتين: ابحث على الأبناء المختصرين، ثم Hydrate الأب المعتمد أوجوارًا محدودًا بعد الترتيب. قد يكون الأب قسمًا أومجموعة بنود أوجدولًا، وليس المستند كاملًا.
لا تضع كل ابن وكل أب في السياق النهائي؛ فهذا يكرر النص ويستهلك التوكنز ويعطي مصدرًا واحدًا وزنًا زائدًا. أزل التكرار حسب نطاق المصدر، واختر أصغر دليل يجيب السؤال، ووسّع فقط عندما يعتمد الابن على تعريف أواستثناء أواسم خارج حدوده. اجعل التوسيع حتميًا حتى ينتج الاسترجاع نفسه حزمة سياق يمكن تفسيرها.
أضف المقاطع المجاورة بعد الاسترجاع لا قبله
يفيد الجوار عندما تقع النتيجة وسط شرح متعدد الأجزاء. احفظ معرف المقطع السابق واللاحق داخل إصدار المستند والقسم نفسيهما. بعد الاسترجاع وTenant Filtering، اجلب جارًا واحدًا إذا بدأت النتيجة كتتمة، أوأشارت إلى تعريف سابق، أوانتهت قبل اكتمال جملة أوقائمة. أعطِ الجار أولوية أقل، واحتفظ بالنتيجة الأصلية التي بررت التوسيع.
لا تجعل الجوار يعبر عميلًا أونسخة مستند أوقسمًا. ولا توسع كل نتيجة آليًا؛ خمس نتائج مع جارين لكل واحدة قد تصبح خمسة عشر مقطعًا متداخلًا تدفن الدليل. قس هل يحسن التوسيع دعم الإجابة وRecall في الأسئلة التي تحتاج فعلًا عدة مقاطع محلية.
استخدم التداخل فقط للعناصر الكبيرة
لا يستطيع Overlap إعادة بناء هرمية العناوين أومخطط الجدول. تطبق Unstructured التداخل افتراضيًا عندما يضطر النظام إلى قطع عنصر دلالي كبير، وتحذر الوثائق من أن تطبيقه بين المقاطع الطبيعية قد يلوث حدودًا نظيفة. ابدأ بلا تداخل بين العناصر السليمة، وأضف قدرًا صغيرًا فقط داخل نص سردي أوكود كبير عندما سيقطع الحد جملة أوتعريفًا أوبلوك.
سجّل نطاق الحروف أوالتوكنز الأصلي حتى تزيل النص المكرر بعد الاسترجاع. اضبط التداخل عبر التقييم لا الحدس. التداخل الأكبر يزيد حجم الفهرس وقد يملأ Top-k بنسخ شبه متطابقة ويقلل تنوع المصادر دون إضافة دليل.
أضف سياقًا فقط للمقاطع الغامضة منفردة
تضيف Contextual Retrieval من Anthropic سياقًا قصيرًا خاصًا بكل مقطع قبل بناء الفهرس الدلالي وBM25. يصلح مثالها جملة مالية لا تذكر الشركة أوالربع. يفيد ذلك عندما يستخدم النص ضمائر أواختصارات أومصطلحات تعتمد على القسم، لكنه ليس بديلًا عن استعادة التخطيط الصحيح.
ولّد السياق من إصدار مستند مصرح به، وافصله عن النص الأصلي، وخزّن Prompt وإصدار النموذج. لا تعرض السياق المولّد كاقتباس أومصدر. في ملفات كثيرة، يكفي مسار القسم الحتمي وعنوان المستند وتاريخه ورؤوس الجدول بكلفة ومخاطرة أقل. قارن Metadata-derived Context بالسياق المولد على الأسئلة المحجوبة نفسها قبل إضافة مرحلة جديدة إلى Ingestion.
اعرف متى يكون Search أوSQL أوAPI أفضل
استخدم البحث الدلالي أوHybrid Search لاكتشاف المعرفة السردية، وLexical Search لأكواد الأخطاء وأرقام الموديلات والبنود الدقيقة، وSQL للحساب والتجميع والنطاقات والحقائق الجدولية المرجعية، وAPI مباشرًا للمخزون وحالة الطلب والبيانات التشغيلية المتغيرة. يستطيع RAG شرح سياسة الاسترجاع، لكن الحالة الحالية لطلب الاسترجاع موجودة في نظام المعاملة.
الحد المفيد هو قابلية إعادة الإنتاج: إذا وجب إعادة حساب الإجابة بدقة من صفوف محددة النوع، فاستخدم Query Engine ودع النموذج يشرح النتيجة. وإذا كانت المهمة إيجاد مقاطع وصياغة خلاصة من نصوص متنوعة، فالاسترجاع مناسب. يمكن لمساعد إنتاجي استخدام الاثنين، على أن يختار كود التطبيق الأداة المصرح بها بدل السماح للنص المسترجع بإعادة تعريف الصلاحيات.
قيّم التقسيم قبل تغيير نموذج التضمين
أنشئ أسئلة تكشف الحدود: قاعدة مع استثنائها، وقيمة جدول مع رأسها، وتعريف يستخدم في صفحة لاحقة، وقائمة تعبر الصفحات، وRunning Header مكرر، وفقرة ممسوحة، وسؤال لا إجابة له. علّم أصغر نطاق دليل كافٍ وأي Structured Lookup مطلوب. قس Recall للمقطع الابن ضمن k، واسترجاع دليل الأب، ونسبة التكرار، ودقة صفحة الاستشهاد، ونسبة توكنز السياق التي تدعم الجواب.
حلل الفشل حسب المرحلة. إذا فقد OCR إشارة السالب فلن يفيد تعديل البحث. وإذا عاد الابن الصحيح لكن توسيع الأب حذف الاستثناء فأصلح Context Construction. وإذا حضر الدليل وفشلت الإجابة فقيّم التوليد. ثبّت مجموعة Held-out عند تغيير متغير واحد. يشرح دليل تقييم RAG هذا الفصل بتفصيل أكبر.
مخطط الإنتاج وقائمة الإطلاق
المسار الموثوق هو: صنّف الملف، واستخرج التخطيط، وخزّن العناصر محددة النوع، وتحقق من ترتيب القراءة، وأنشئ أبناء داخل الأقسام، واعزل الجداول، واربط السلالة، وأنشئ التضمينات والفهرس، واسترجع ضمن Tenant Scope، وأعد الترتيب، ووسّع الآباء أوالجيران المصرح بهم، وأزل تكرار نطاقات المصدر، وابنِ سياقًا مستشهدًا به، ثم قيّم الإجابة. اجعل كل مرحلة Versioned وقابلة للاستئناف.
ابدأ بعائلة مستندات واحدة بدل تفعيل كل PDF. قارن خط Structure-aware مع Fixed-window بسيط على الأسئلة نفسها. راقب فشل التحليل ونسبة المقاطع الصغيرة وتقسيم العناصر الكبيرة وثقة استخراج الجداول ونمو الفهرس وزمن الاسترجاع وصحة الاستشهادات. أعد الفهرسة من العناصر المخزنة عند تغيير القواعد، واسحب نسخ المقاطع القديمة ذريًا حتى لا يبقى دليل قديم قابلًا للبحث.
اربط النتيجة مع خط إنتاج RAG الكامل وHybrid Retrieval في Qdrant. القاعدة التصميمية بسيطة: احفظ معنى المستند قبل تحسين الفهرس المتجهي. المقطع الجيد ليس قصيرًا فقط؛ بل قابل للاسترجاع منفردًا، ومتتبع إلى مصدره، وقابل للتوسيع دون عبور حد أمني أودلالي.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.