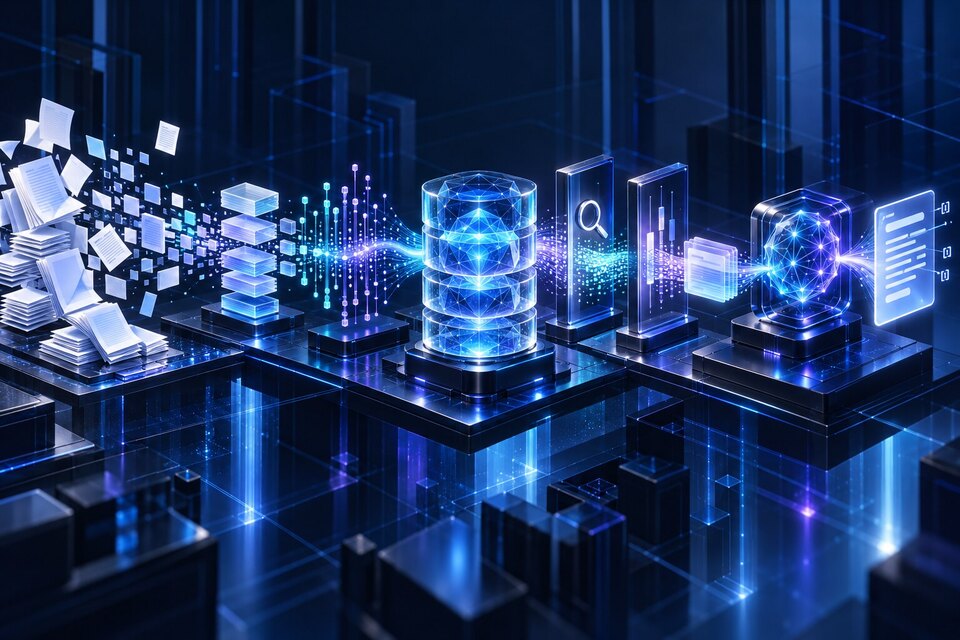
Hybrid Search في Qdrant هو مسار استرجاع كامل، وليس زرًا يرفع جودة RAG تلقائيًا. يسترجع Dense Embeddings التشابه في المعنى، ويحافظ Sparse Retrieval على الكلمات الدقيقة والمعرّفات والأسماء النادرة، ثم يدمج Fusion قائمتي المرشحين، وتفرض الفلاتر نطاق العميل والعمل، ويمكن لـReranker أن ينفق حوسبة إضافية على مجموعة صغيرة. يستحق هذا التعقيد عندما تثبت الأسئلة المعلّمة أن Dense وSparse يفشلان في حالات مختلفة، ولا يلزم عندما يحقق مسار واحد هدف الصلة والزمن والتكلفة.
ابدأ من العطل الذي يصلحه كل مسار
تنجح Dense Embeddings عندما يعيد المستخدم صياغة ما في المستند. يمكن لسؤال «كيف أرجع طلبًا تالفًا؟» أن يطابق سياسة عنوانها «إجراء Refund للمنتج المعيب» حتى دون كلمات مشتركة. لكنها قد تفقد SKU أو Error Code أو رقم فاتورة أو اسم منتج عربي نادر، لأن التمثيل يضغط التفاصيل اللفظية داخل Vector ثابت الأبعاد.
يحافظ Sparse Retrieval مثل BM25 على دليل الكلمات. قد يعثر على NY-4821 أو عبارة قانونية مطابقة، لكنه أضعف عندما يستخدم السؤال والمستند مفردات مختلفة للمعنى نفسه. يفيد Hybrid Search فقط إذا كان الفشلان متكاملين. إذا غاب المقطع الصحيح عن الفهرس أو لم تدعم Embedding لغته أو استبعدته الصلاحيات، فلن ينشئ Fusion دليلًا لم يظهر في أي قائمة.
ابنِ مجموعة أسئلة معلّمة قبل تغيير المعمارية. ضمّن سؤالًا طبيعيًا ومعرّفًا دقيقًا وعربية مختلطة بالإنجليزية وخطأ إملائيًا وسؤالًا قصيرًا ملتبسًا وحالة يجب الامتناع فيها عن الإجابة. سجّل Chunk IDs الصحيحة والعميل المسموح لكل سؤال، ثم قارن Dense وحده وSparse وحده والنتيجة المدمجة على العلامات نفسها. يوصي دليل ضبط Hybrid Search بالتأكد أن Fusion يتفوق على أفضل مسار منفرد بدل افتراض أن فهرسين أفضل دائمًا.
صمّم Collection حول Named Vectors وحقائق قابلة للفلترة
احفظ Dense وSparse كـNamed Vectors داخل Point نفسه. ويجب أن يحمل Payload الحقائق التي لا يجوز استنتاجها من Embedding: tenant_id واللغة وdocument_id ونسخة المستند ونوع المصدر وحالة النشر وأي قيد منتج يستخدم وقت البحث. الـPayload للنطاق والفلترة، والـVector للصلة. لا تضع التفويض داخل النص فقط ثم تتوقع من Similarity Search فرضه.
أنشئ Payload Indexes قبل إدخال البيانات للحقول التي ستستخدمها الفلاتر. تشرح وثائق الفهرسة أن هذه الفهارس تساعد في تقدير Cardinality وتخطيط الاستعلام، وأن Filterable HNSW يستفيد من الحواف الإضافية عندما توجد الفهارس قبل بناء الرسم. إذا أضفتها بعد البيانات فأعد بناء HNSW للاستفادة. ويمكن لـStrict Mode رفض فلتر على حقل غير مفهرس كي يظهر الخطأ عند API بدل تحوله إلى بطء إنتاجي.
استخدم Point IDs حتمية مشتقة من هوية المستند والمقطع، وخزّن embedding_model_version للهجرة. تحديث مستند يجب أن يكتب نسخة جديدة ويتحقق منها ثم يسحب القديمة. لا تخلط أبعادًا أو Semantic Spaces مختلفة تحت Named Vector واحد. تسمح Named Vectors أو Collections بنمط Blue-Green بقياس هجرة نموذج Embedding والتراجع عنها.
طبّق نطاق العميل داخل كل Prefetch
يجب أن يوجد فلتر العميل داخل Dense Prefetch وSparse Prefetch معًا. تطبيق التفويض بعد Fusion يهدر المرشحين وقد يكشف إشارات صلة بين العملاء. كما يمكن أن يترك نتائج مسموحة قليلة لأن Candidate Budget استُهلك في Points غير متاحة. ابنِ النطاق داخل كود موثوق من هوية المستخدم؛ لا تأخذ tenant_id من النموذج أو من إدخال المستخدم الخام.
لعدد كبير من العملاء الصغار، توثق Qdrant استخدام Collection مشتركة مع Keyword Payload Index يحمل is_tenant=true. تساعد الإشارة في تجميع نقاط العميل وتحسين القراءة الخاصة به. قد يناسب User-defined Sharding عددًا أصغر من العملاء الكبار، ويمكن لتصميم Tiered إبقاء الصغار معًا وترقية العملاء الثقيلين إلى Shards مستقلة. أما Collection لكل عميل فتعطي حدًا إداريًا قويًا لكنها تضيف كلفة تشغيلية ولا تكون البداية المناسبة عند أعداد ضخمة.
للترتيب اللفظي حد آخر. يوضح دليل Multi-tenancy أن IDF الافتراضي يحسب إحصاءاته على مستوى Shard، فيمزج مفردات العملاء عند التقسيم بالـPayload. منذ Qdrant 1.19 يمكن لمعامل idf تعريف Corpus خاص بالعميل مستقل عن Retrieval Filter الأضيق. دون ذلك، قد تبدو كلمة نادرة عند متجر شائعة لأن متاجر أخرى تستخدمها كثيرًا. فلتر الاسترجاع وIDF Corpus يحلان مشكلتين مختلفتين.
نفّذ Dense وSparse Prefetch قبل Fusion
تنفذ واجهة Hybrid Queries استعلامات Prefetch ثم تطبق Main Query على نتائجها. امنح كل Prefetch حد مرشحين أكبر من عدد النتائج النهائي. Fusion يعيد ترتيب ما استُرجع فقط. طلب عشر نتائج من قائمتين تحتوي كل منهما عشرة عناصر لا يترك مساحة كافية للتعافي؛ Candidate Pool أعمق يرفع Recall لكنه يزيد CPU والوصول للذاكرة وكلفة المراحل التالية.
يوضح المثال مسارين وفلتر صلاحيات واحدًا وReciprocal Rank Fusion. يجب أن ينتج نموذج Sparse المستخدم في الفهرسة Sparse Query، ويجب أن يستخدم Dense Query نسخة نموذج Dense نفسها. القيم والحدود أمثلة تضبط على علامات حقيقية وزمن إنتاجي.
const tenantFilter = {
  must: [
    { key: 'tenant_id', match: { value: authorizedTenantId } },
    { key: 'state', match: { value: 'published' } }
  ]
};

const result = await qdrant.query('knowledge', {
  prefetch: [
    { query: denseVector, using: 'dense_v3', filter: tenantFilter, limit: 80 },
    { query: sparseVector, using: 'bm25', filter: tenantFilter, limit: 80 }
  ],
  query: { rrf: { k: 2, weights: [1.0, 1.0] } },
  limit: 20,
  with_payload: ['document_id', 'chunk_id', 'version', 'language']
});
يحتاج Pagination الانضباط نفسه. توضح Qdrant أن offset يطبق على Main Query، لذلك يجب أن يغطي Limit لكل Prefetch مجموع final limit وoffset على الأقل. وقد تنتج الصفحات العميقة ترتيبًا غير مستقر عندما يتغير Index. فضّل تجربة نتائج محدودة أو عقد Continuation على مستوى التطبيق بدل التعامل مع ANN كأنه ترتيب SQL ثابت.
اختر RRF أو DBSF بحسب معنى الدرجات
يستخدم RRF ترتيب النتائج لا قيمة Scores الخام. هو بداية آمنة لأن Cosine Similarity وBM25 يعملان بمقاييس غير متوافقة. يحصل المستند القريب من القمة في القائمتين على دعم منهما حتى لو لم يمكن جمع الدرجات رقميًا. تدعم Qdrant Weights وk؛ اضبطهما على Training Split ثم تحقق من القرار على Held-out Queries.
يطبع DBSF توزيع درجات كل قائمة على مقياس قابل للجمع. يمكنه الحفاظ على حقيقة أن نتيجة Dense الأولى سبقت الثانية بفارق كبير، بينما يحول RRF الفرق إلى خطوة ترتيب فقط. يفيد هذا إذا كان حجم الفارق إشارة مستقرة، لكن قائمة صغيرة أو توزيعًا شاذًا قد يجعلان التطبيع مضطربًا. توصي Qdrant بـRRF كافتراضي آمن دون Score Priors، وDBSF عندما تثق بتوزيع الدرجات، وWeighted RRF عندما يتيح Labeled Data الضبط.
تجنب Alpha ثابتًا يجمع Dense وSparse Scores دون Normalization. قيمة Cosine المحدودة ودرجة BM25 غير المحدودة لا تملكان وحدة واحدة، وتتغير النطاقات بين الأسئلة. قد يسيطر مسار لأن أرقامه أكبر لا لأن نتائجه أفضل. يلغي RRF مشكلة المقياس، بينما يطبّع DBSF كل قائمة. ويجب أن يتفوق الفائز على Dense وSparse في أسئلة المنتج الفعلية.
أضف Reranker بعد سلامة Candidate Recall
يحسن Fusion ترتيب المرشحين المسترجعين. يستطيع Cross-encoder أو Late-interaction Reranker فحص السؤال والنص بدقة أعلى، لكنه لا يستعيد مقطعًا أخرجه Prefetchان. قِس Recall عند Candidate Depth قبل nDCG أو MRR بعد إعادة الترتيب. إذا كان Recall ضعيفًا فأصلح Chunking أو تغطية النموذج أو الفلاتر أو العمق أولًا.
يسترجع مسار عملي عشرات أو مئات المرشحين لكل جهة، ثم يدمجها ويعيد ترتيب Top Set محدود، وبعدها يجلب النص الكامل من المصدر الموثوق تحت سياسة العميل نفسها. Hydration بعد الترتيب يبقي Payload صغيرًا، ويسمح لـPostgreSQL RLS أو سياسة مصدر الحقيقة بإعادة التحقق قبل بناء سياق النموذج. احفظ ما يكفي لتعريف المقاطع وترتيبها، لا كل النص الخاص داخل Vector Store لمجرد السهولة.
يضيف Reranking زمنًا وتكلفة. احتفظ به إذا حسّن نتائج منتج قابلة للقياس: Citations خاطئة أقل، أو أول نتيجة مفيدة أفضل، أو تصعيد أقل. أزله إذا حقق Fusion الهدف. ويجب على Context Construction إزالة التكرار بين المقاطع، وتحديد عدد المصادر لكل مستند، والحفاظ على العناوين وإضافة Citation IDs ثابتة قبل إرسال السياق إلى LLM.
اضبط HNSW وQuantization بعد قياس الصلة
بحث HNSW تقريبي. رفع hnsw_ef يستكشف مرشحين أكثر وقد يرفع Recall مقابل تكلفة أعلى. يضيف Filterable HNSW حواف مبنية على Payload Indexes، ومع ذلك قد تفصل تركيبات الفلاتر الصارمة الرسم؛ وتوثق Qdrant خوارزمية ACORN لاستكشاف أعمق عندما تحجب الفلاتر الجيران المباشرين. لا تنسخ ef ثابتًا من مشروع آخر. اختبر بفلاترك وعدد Shards والتوازي الحقيقي.
تبادل Quantization دقة التمثيل مع الذاكرة والسرعة. تدعم Qdrant Scalar وBinary وProduct وTurboQuant ولكل منها مقايضة مختلفة. احتفظ بالـOriginal Vectors لإعادة التقييم حين يتطلب التصميم، وقارن Recall مع Baseline غير مضغوط. Candidate Stage أسرع يحذف المستند الصحيح يجعل LLM أرخص لكنه يجعل المنتج أسوأ.
يشمل Capacity Planning تمثيلين للمتجهات وفهارسهما وPayload Indexes وWAL والنسخ وReranker. Hybrid Search ليس Query Modifier مجانيًا. تتبع p50 وp95 وp99 لكل من Dense Prefetch وSparse Prefetch وFusion وReranking وHydration كي يظهر عنق الزجاجة. وسجّل عدد المرشحين بعد الفلترة؛ هبوطه قد يكون خلل صلاحيات أو حالة نشر لا مشكلة Vector.
قيّم المسار كنظام قرار
قسّم النتائج بحسب نوع السؤال. قد تحتاج المعرّفات الدقيقة وزنًا لـSparse، وقد تحتاج أسئلة الدعم المفاهيمية Dense، وقد تكشف العربية المختلطة بالإنجليزية فجوة في Embedding أو Tokenizer. استخدم Recall عند Candidate Depth، وnDCG@k أو MRR للترتيب النهائي، وZero-result Rate تحت فلتر كل عميل. ثم قِس Latency وحجم الفهرس والتكلفة وGroundedness بصورة منفصلة. يخفي Average واحد فئة مهمة مكسورة.
نفذ Ablation واضحًا: Dense فقط، Sparse فقط، RRF افتراضي، RRF مضبوط، DBSF، ثم أفضل Fusion مع Reranker ودونه. ثبّت Chunking وEmbeddings خلال المقارنة، وبعدها غيّر متغيرًا واحدًا في كل تجربة. خزّن Configuration ونسخ النماذج مع نتيجة كل تشغيل كي يمكن إعادته. يشرح دليل تقييم RAG كيف تفصل غياب الدليل عن خطأ التوليد.
لا يناسب Hybrid Search سؤالًا يتكون من Database Key صريح فقط، أو حالة يستطيع SQL إجابتها حتميًا، أو Corpus صغيرًا يكفيه Text Index أبسط، أو مجموعة علامات لا تظهر تحسنًا عن مسار واحد. كما لا يجعل المستند القديم حديثًا. المخزون وحالة الطلب والصلاحيات تحتاج غالبًا أدوات Live مصرحًا بها، لا Embedding Index.
انشره تدريجيًا بعقد واضح
ابدأ بـShadow Queries لا تغير الإجابات. سجّل مرشحي Dense وSparse وFusion للطلب نفسه مع إبقاء المسار الحالي هو المستخدم. راجع الاختلافات، وعلّم عينة ممثلة، واختر Fusion وCandidate Depth بالدليل. بعد ذلك فعّل المسار الجديد لنسبة صغيرة خلف Feature Flag مع Fallback فوري إلى Retriever السابق.
قبل التوسع اختبر عزل العملاء وIDF Corpus فارغًا وحذف المستند وهجرة نموذج Embedding وإعادة بناء الفهرس وCold Cache وفشل Shard وموجة استعلامات متزامنة. تعامل مع أي نتيجة Cross-tenant كحادث أمني لا Metric صلة. واحتفظ بمعرف المصدر والمقطع اللذين وصلا إلى التوليد كي يمكن تدقيق Citations.
العقد الإنتاجي صريح: كلا Retriever يطبق Scope موثوقًا واحدًا، ولكل منهما Candidate Depth كافٍ، ويُختار Fusion من العلامات، ويظل Reranking اختياريًا، وتعيد Hydration فحص الصلاحية، ويحمل السياق Citations. يستحق Hybrid Search تعقيده فقط إذا حسّن هذا المسار المقاس أسئلة حقيقية. ولتصميمه وتنفيذه، راجع خدمة تكاملات AI وأنظمة الاسترجاع.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.