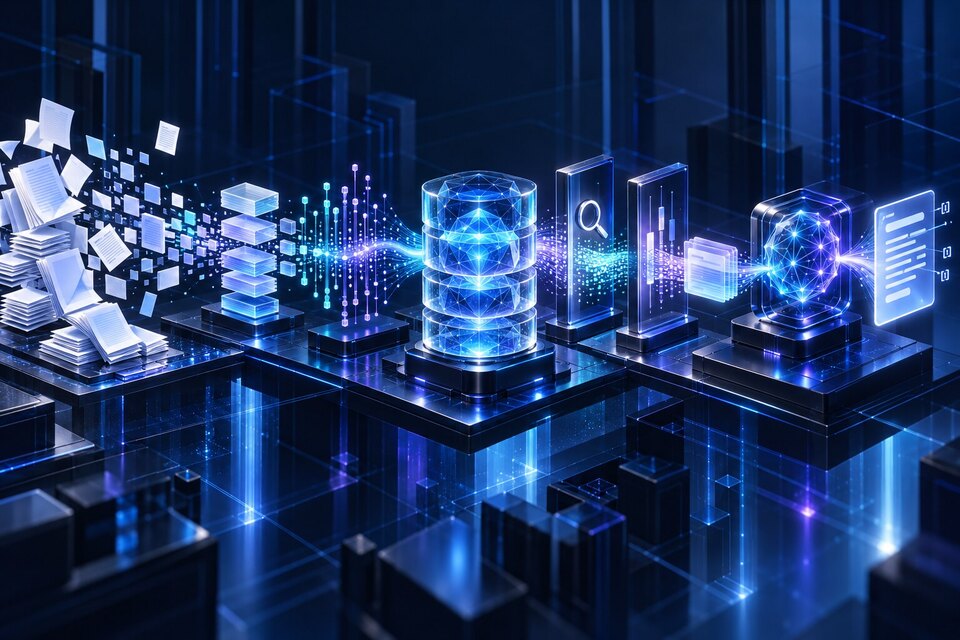
خط إنتاج RAG الجاهز للعمل ليس «ضع ملفات PDF في قاعدة متجهات واسأل LLM». إنه نظامان بإصدارات واضحة يربطهما عقد أدلة: مسار غير متزامن يحلل المصادر المصرح بها ويقسمها ويولّد تضميناتها ويفهرسها، ومسار مباشر يفهم السؤال ويسترجع المرشحين ويعيد ترتيبهم ويبني سياقًا محدودًا بمراجع ثم يطلب من النموذج الإجابة من هذه الأدلة فقط. يناسب RAG المعرفة الكبيرة والمتغيرة وغير المهيكلة، بينما يكون SQL أو البحث العادي أفضل غالبًا للحقائق المنظمة الدقيقة والمعاملات والعثور المباشر على مستند.
يعتمد هذا الدليل على ورقة RAG الأصلية ووثائق OpenAI وAnthropic وQdrant وVoyage الرسمية التي روجعت في 5 أكتوبر 2026. أمثلة المزودين توضح الواجهات والمقايضات وليست وعود benchmarks عامة. نتائج Contextual Retrieval المنشورة من Anthropic مثلًا هي تجارب الشركة على بيانات وإعدادات اختارتها، لذلك يجب إعادة التقييم على corpus المنتج نفسه.
ابدأ بالقرار: RAG أم Search أم SQL
يستحق RAG تعقيده عندما يطرح المستخدم أسئلة طبيعية تحتاج تركيب إجابة من مستندات غير مهيكلة كثيرة، وعندما تتغير المعرفة أسرع من تدريب النموذج، وعندما تهم معرفة المصدر. السياسات والأدلة والعقود وسجل الدعم والوثائق التقنية أمثلة مناسبة. قدّمت ورقة RAG الأصلية الفكرة على أنها دمج ذاكرة النموذج البارامترية بذاكرة خارجية صريحة، جزئيًا لتسهيل تحديث المعرفة وتوفير provenance.
لا تمرر كل سؤال عبر embeddings. استخدم SQL لسؤال «كم المبلغ المدفوع للفاتورة 1042؟» لأن الـschema والقيمة الحالية والشرط محددة. استخدم محرك بحث للعثور على صفحات فيها error code أو اسم منتج أو عبارة مطابقة. استخدم API حتمية لحالة الحساب والصلاحيات. استخدم fine-tuning عندما تكون المشكلة سلوكًا أو أسلوبًا أو تحويلًا متكررًا لا نقص حقائق. وإذا كان corpus صغيرًا وثابتًا ويتسع بأمان داخل نافذة النموذج، فقد يكون تمريره كاملًا أبسط من الاسترجاع.
يصنف router مفيد الطلب قبل الاسترجاع: المعاملات والأسئلة المنظمة تذهب إلى الأدوات وSQL، والأسئلة الملاحية إلى lexical search، وتركيب المعرفة إلى RAG، والطلبات غير المدعومة أو الحساسة تتوقف. يحتاج الـrouter نفسه إلى eval لأن اختيار مسار خاطئ قد يكون أخطر من similarity score ضعيف.
افصل مساري الفهرسة والسؤال
يمتلك المسار غير المتزامن ingestion المصدر. يستقبل إصدار المستند، ويحفظ الأصل، ويستخرج نصًا منظمًا، ويسجل العناوين ومواضع الصفحات، وينشئ الأجزاء والتضمينات، ويكتب النقاط القابلة للبحث، ثم يعلن الإصدار searchable فقط بعد دوام كل artifact مطلوب. يجب أن تكون كل مرحلة idempotent وقابلة للاستئناف. لا يجوز أن يترك فشل embedding batch نصف مستند ظاهرًا بجوار الإصدار السابق المكتمل.
يمتلك المسار المباشر ميزانية latency. يوثق المستخدم ويشتق نطاق العميل وACL، وينظف السؤال أو يعيد صياغته عند وجود مبرر، ويشغّل فروع الاسترجاع، ويدمج المرشحين ويعيد ترتيبهم، ويحمل النص الرسمي، ويبني السياق، ويستدعي LLM، ويتحقق من المراجع. لا تجعل مسار السؤال يحلل الملفات أو يصلح index. أرسل هذه الأعمال إلى طوابير مستقلة بتزامن منفصل لأن الاستخراج والتضمين والفهرسة لها أنماط ذاكرة وrate limits وشبكة مختلفة.
اربط المسارين بمعرفات ثابتة: `tenant_id` و`document_id` و`document_version` و`chunk_id` ومسار القسم وموضع المصدر وسمات ACL وcontent checksum وإصدار embedding وindex. نقطة المتجه إسقاط للاسترجاع وليست source of truth. حمّل النص النهائي والصلاحيات الحالية من المخزن الرسمي عندما تبرر المخاطر ذلك.
قسّم وفق المعنى والبنية لا رقمًا عالميًا
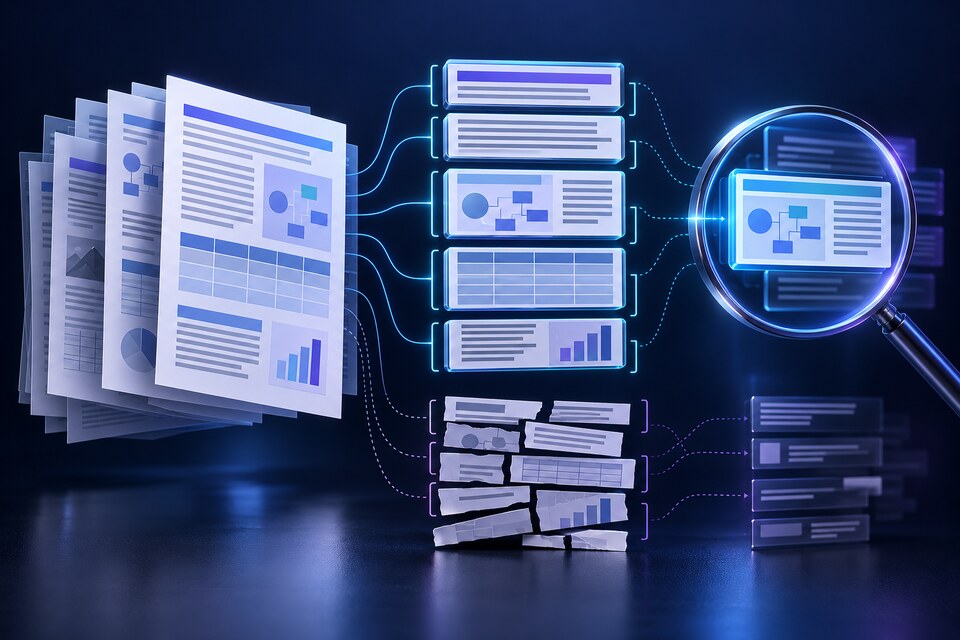
يقرر chunking ما يمكن استرجاعه كوحدة. نوافذ التوكن الثابتة baseline مقبول، لكنها قد تفصل الجدول أو الإجراء أو التعريف عن عنوانه. فضّل حدودًا واعية بالبنية: العناوين والفقرات للنثر، وحدود function أو class للكود، وصفوفًا مع headers للجداول، وبنودًا للعقود، وأدوار الحديث للمحادثات. احتفظ بمسار البنية metadata حتى إن كان النص مفهومًا وحده.
يجب أن يكون الجزء صغيرًا بما يكفي لتمثيل فكرة بحث واحدة وكبيرًا بما يكفي للإجابة عن سؤال فرعي مفيد. يحمي overlap الحقائق العابرة للحدود، لكن المبالغة تضاعف تكلفة embedding وتعيد near-duplicates. بدل التخمين، ابنِ مجموعة أسئلة من المهام الحقيقية وجرّب أحجامًا وقواعد حدود ونسب overlap. قِس هل ظهر جزء واحد على الأقل يحمل الإجابة ضمن مجموعة المرشحين.
يفيد parent-child retrieval عندما تبحث الأجزاء الضيقة جيدًا لكن الإجابة تحتاج سياق القسم: افهرس child ثم حمّل parent أو الجيران المباشرين بعد الاسترجاع. ويمكن للسياق المضاف استعادة الهوية المفقودة. تضيف طريقة Contextual Retrieval من Anthropic وصفًا قصيرًا خاصًا بكل جزء مشتقًا من المستند الكامل قبل embedding والفهرسة النصية. أبلغت Anthropic عن انخفاض فشل الاسترجاع في تجاربها، لكن هذا لا يبرر توليد السياق عشوائيًا؛ فقد يضيف معلومات خاطئة وتكلفة وعبء versioning، لذلك قيّم الأجزاء الأصلية والسياقية منفصلة.
عامل Embeddings كعقد بيانات بإصدار
ينتج embedding من model محدد ونمط input ومعالجة مسبقة وأبعاد output. تغيير أي منها يغير فضاء المتجهات. خزّن `embedding_model` والأبعاد وإصدار pipeline مع كل نقطة، ولا تستعلم عن collection بمتجه من نموذج غير متوافق. تبني الهجرة named vector أو collection جديدة، وتعمل backfill، وتقارن recall وlatency، وتحول القراءات تدريجيًا، وتبقي نافذة rollback.
تصف وثائق OpenAI للتضمينات embedding بأنه تمثيل متجهي مفيد للبحث والتجميع والتوصيات والتصنيف. الاستنتاج الإنتاجي هو مطابقة input مع عقد النموذج: ميّز document وquery modes عندما يوفرهما المزود، ونظّف النص بالطريقة نفسها، واجمع الطلبات ضمن حدود المزود، وأعد المحاولة بكتابات idempotent، وسجّل الفشل لكل chunk. لا تعلن المستند INDEXED حتى تحمل كل الأجزاء المقصودة إصدار embedding المتوقع.
أزل التكرار قبل دفع تكلفة التضمين. يستطيع content checksum إعادة استخدام الأجزاء غير المتغيرة عبر إصدارات المستند، لكن أدخل contextual prefix وإصدار preprocessing في الهاش. لا تستخدم اسم الملف الخام كهوية. شفّر الأصل والنص المستخرج حسب الحاجة، ولا ترسل المستندات إلى مزود embeddings إذا كانت معالجة بياناته لا تناسب التزامات أمان المنتج.
صمّم Qdrant حول الاسترجاع والعزل
تحدد Qdrant collection حجم المتجه وسلوك distance، لذلك تتبع عقد embedding لا عدد business entities. ضع حقول payload المؤثرة في الفلاتر أو provenance قرب المتجه: العميل والمستند والإصدار ونوع المحتوى واللغة والتواريخ ووسوم ACL وموضع المصدر. أنشئ payload indexes للحقول المستخدمة في الفلاتر؛ وجود الحقل في payload لا يضمن كفاءة التصفية.
في multitenancy لا تقبل tenant filter مباشرة من الطلب العام. ابنِه من النطاق الموثق واحقنه في كل فرع query. توصي إرشادات Qdrant للـmultitenancy بالتقسيم عبر payload لعدد كبير من العملاء الصغار، وتوثق keyword index واعيًا بالعميل؛ ويمكن تخصيص shards أو استخدام tiered sharding للعملاء الأكبر. تعتمد topology الصحيحة على الحجم والعزل وخطر noisy neighbor والتشغيل، لا على شعار أن collection واحدة أو collection لكل عميل صحيحة دائمًا.
الفلاتر بناء استعلام حساس للأمان. اختبر dense وsparse وrecommendation وscroll endpoints بالنطاق المفروض نفسه. إذا وسعت query rewrite الكيانات أو الزمن فلا يجوز أن توسع التفويض. خزّن النص الرسمي خارج قاعدة المتجهات عندما يجب إعادة تقييم السياسة وقت القراءة، ثم حمّل `chunk_id` المختارة عبر repository مصرّح به.
استرجع على نطاق واسع ثم أعد الترتيب بدقة
يلتقط dense retrieval التشابه الدلالي لكنه قد يفوت المعرفات والمصطلحات الدقيقة. يلتقط lexical search هذه السلاسل لكنه قد يفوت إعادة الصياغة. يشغّل hybrid retrieval الاثنين ويدمج الرتب لينتج مرشحين بتغطية أعلى. يشرح دليل Qdrant للبحث الهجين بالتفصيل RRF وDBSF وفلاتر payload؛ المهم هنا هو معاملة fusion كمرحلة توليد مرشحين لا كسياق الإجابة النهائي.
يسجل reranker السؤال وكل مرشح بتفاعل أغنى من embeddings المستقلة. تكلفته أعلى، لذلك طبقه على مجموعة مرشحين محدودة لا corpus كاملًا. تعرض وثائق Voyage reranker حساب relevance للسؤال مع المستند؛ وللمنتجات الأخرى حدود ومعاني scores مختلفة. اختر عدد مرشحي rerank وعدد أجزاء context بالتقييم وميزانية التوكن، لا بنسخ قيم top-N وtop-K من مزود.
قد تحل query rewriting الضمائر وتوسع الاختصارات أو تنتج بدائل لفظية، لكن احتفظ بالسؤال الأصلي وقيّم rewrite كمكوّن مستقل. قد تنحرف إعادة الصياغة المولدة عن نية المستخدم. استخرج exact IDs قبل semantic rewriting، واجمع الفلاتر حتميًا. وإذا حقق الاسترجاع الأولي recall والترتيب المطلوبين فتجاوز reranking لتوفير latency والتكلفة.
ابنِ السياق كأدلة لا ككومة نصوص
Context construction مكوّن منتج حتمي. أزل الأجزاء المتكررة وشبه المتكررة، وفضّل أحدث إصدار مصرح به، وادمج الجيران فقط من المصدر نفسه، واحجز توكنات للتعليمات وسؤال المستخدم والإجابة. رتّب الأدلة بحسب الفائدة لا vector score فقط؛ قد يسبق تعريف قصير قسمًا طويلًا داعمًا. احتفظ بمعرفات citation ثابتة مربوطة بإصدار المستند والموضع.
افصل التعليمات عن النص المسترجع. المستندات بيانات غير موثوقة وقد تحتوي prompt injection. وضح للنموذج أن النص المسترجع لا يستطيع تجاوز system rules أو طلب أدوات. أزل markup النشط حيث يلزم، وحدد مساهمة كل مصدر حتى لا يهيمن مستند واحد، ولا تمرر metadata ACL الخفية ما لم تحتجها الإجابة. يجب أن يتضمن السياق metadata تكفي مرجعًا مفهومًا للإنسان دون كشف مسارات التخزين الداخلية.
يمكن لـcontext builder توضيحي فرض الميزانية قبل استدعاء النموذج:
const candidates = await retrieve({ query, scope, dense: 40, sparse: 40 });
const ranked = await rerank(query, deduplicate(candidates));
const hydrated = await repository.loadAuthorized(scope, ranked.map(x => x.chunkId));

const context = buildContext(hydrated, {
  maxTokens: 7_000,
  maxPerDocument: 3,
  includeSource: ['documentId', 'version', 'page', 'section'],
});

return generateGroundedAnswer({ query, context, requireCitations: true });
هذه الأرقام ميزانيات مثال وليست توصيات. قِس باستخدام النموذج وcorpus وSLO الفعليين.
اجعل الإجابة تستشهد وتمتنع
اطلب من النموذج الإجابة من الأدلة المقدمة، وإرفاق citation بكل ادعاء جوهري، والتصريح عندما يكون السياق ناقصًا أو متعارضًا. صيغة المرجع وحدها لا تثبت grounding: بعد التوليد، تحقق أن كل citation تشير إلى chunk داخل السياق وأن الاقتباس أو الادعاء مدعوم فعلًا. يجب أن تفشل معرفات citation غير الصحيحة في التحقق بدل الاختفاء بصمت.
تحتاج التعارضات سياسة. فضّل مصدرًا رسميًا ذا effective date عندما يوجد؛ وإلا اعرض الاختلاف واستشهد بالطرفين. لا تجعل similarity score يقرر أي سياسة هي السارية قانونيًا. وفي العمليات عالية الأثر، يجب أن تخبر إجابة RAG المستخدم أو تقترح tool call، لا أن تعدل الإنتاج مباشرة دون تحقق وتفويض حتميين.
احتفظ بدرجة temperature وإصدار prompt وmodel ومعرفات context في trace. خزّن ما يكفي لإعادة إنتاج الفشل دون الاحتفاظ بمحتوى حساس أطول من المسموح. استجابة النموذج view مشتقة؛ تبقى الحقائق الرسمية في أنظمتها المصدرية.
قيّم كل بوابة لا صياغة الجواب فقط
قد تخفي إجابة فصيحة فشل الاسترجاع. ابنِ evaluation set بإصدار يضم أسئلة حقيقية ومستندات متوقعة تحمل الإجابة وnegatives صعبة وأسئلة بلا إجابة وحدود صلاحيات. قسّم metrics حسب المجال واللغة وحجم العميل ونوع السؤال حتى لا يخفي المتوسط فئة معطلة. توصي إرشادات OpenAI للتقييم باختبارات خاصة بالمهمة وبيانات ممثلة وتقييم مستمر مع تغير النظام.
قِس الاسترجاع قبل التوليد: تسأل recall@k هل ظهر جزء يحمل الإجابة، وتقيس MRR أو nDCG جودة الترتيب، وتثبت اختبارات الفلاتر أن النقاط الممنوعة لا تظهر. ثم قِس reranker وcontext builder والإجابة منفصلة: دقة الأدلة وصحة المراجع ونسبة الادعاءات المدعومة وجودة الامتناع وصحة المهمة. تتبع p50 وp95 latency والتوكنات وتكلفة embedding وreranking وعمر الطابور وحداثة index بجانب الجودة.
نفّذ ablations. قارن lexical فقط وdense فقط وhybrid وhybrid مع reranking وتوسيع الأجزاء المجاورة والأجزاء السياقية على الأسئلة نفسها. غيّر مكوّنًا واحدًا كل مرة. قد تزيد recall لكن تنخفض جودة الإجابة إذا امتلأ context بالمشتتات. لا ترقِّ إصدارًا إلا إذا اجتاز بوابات الجودة والأمان والlatency والتكلفة.
أخطاء يجب إخراجها من التصميم
الأخطاء الشائعة صامتة: parser يسقط الجداول، أو chunks تفقد عناوينها، أو query وdocument embeddings تستخدمان إصدارين مختلفين، أو يظهر المستند قبل اكتمال index، أو يبقى مصدر محذوف داخل Qdrant، أو يسقط tenant filter من فرع واحد، أو يفشل reranking ويعيد fallback غير محدود، أو يحذف context truncation المراجع، أو يجيب النموذج بثقة عن سؤال بلا دليل. امنح كل مرحلة state صريحة وسببًا قابلًا للملاحظة.
استخدم blue-green index versions وalias أو switch داخل التطبيق. طابق جدول المستندات الرسمي مع vector points ونفذ tombstone للحذف. ضع حدًا للمرشحين والسياق حتى أثناء تعطل dependency. عرف fallback: قد يكون lexical-only مقبولًا عند تعطل embeddings، وقد يكون تجاوز reranking مقبولًا عندما ترتيب المرشحين قوي، لكن التوليد دون retrieval غير مقبول غالبًا لمسار يتطلب grounding.
يجب أن تحاول اختبارات الأمان الاسترجاع بين العملاء وprompt injection داخل المستندات والمصادر المسمومة والأجزاء الضخمة وتزوير citations. ويجب أن تعيد اختبارات الموثوقية jobs وتكرر الأحداث وتقطع migrations وتنهي اعتمادات المزود. يصبح pipeline جاهزًا للإنتاج عندما يفشل بصورة مغلقة أو يتدهور بتوقع، لا عندما يجيب demo واحدًا عن PDF.
قائمة إطلاق إنتاجية
قبل الإطلاق، حدد الأسئلة التي يجيب عنها RAG وتلك التي تذهب إلى SQL أو search؛ وأصدر parser وchunker وembeddings؛ واحتفظ بالأصل والنص الرسمي؛ ولا تفهرس إلا إصدارات المستند المكتملة؛ واشتق فلاتر العميل وACL من هوية موثوقة؛ وأنشئ payload indexes في Qdrant؛ وقيّم dense وlexical وfusion وreranking؛ وابنِ ميزانية توكن حتمية؛ واحفظ provenance للمراجع؛ وتحقق من الادعاءات والامتناع؛ وتتبع إصدارات المكونات وlatency؛ وطابق عمليات الحذف؛ واحتفظ بـeval set ممثلة وواعية بالصلاحيات.
للتعمق في العقود المحيطة، اقرأ تقييم جودة الاسترجاع، وHybrid Search في Qdrant، وسياق العميل الآمن في SaaS، وعزل العملاء في PostgreSQL.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.