لا يبدأ حل أعطال DNS في Kubernetes بزيادة Replicas أو إضافة Cache تلقائيًا. تتبّع Lookup واحدًا من التطبيق إلى إعداد Resolver داخل Pod ثم Search Suffixes وService الخاصة بـkube-dns وCoreDNS وأي Upstream Resolver، وبعدها أصلح الطبقة التي تفشل فعلًا. يمكن لـNodeLocal DNSCache تقليل Cross-node Latency وفقد UDP وضغط conntrack، لكنه لا يصلح Service Record مفقودة أو CoreDNS Pods غير سليمة أو Upstream لا يمكن الوصول إليه أو تطبيقًا يولد Lookups بلا ضابط. هذا الدليل موجه لفرق Platform التي تواجه Name Resolution متقطعًا يؤثر في Availability أو Tail Latency.
يوثق Kubernetes أن Pods ذات `ClusterFirst` ترسل أسماء Cluster Domain إلى Cluster DNS وتحول الأسماء الخارجية إلى Upstream. ويشغّل التصميم الرسمي لـNodeLocal DNSCache وكيل Cache كـDaemonSet على كل Node لتجنب جزء من مسار kube-proxy DNAT وConnection Tracking. ويوضح CoreDNS أن Cache TTL حد أقصى لا يطيل TTL الأصلية للسجل. هذه حقائق موثقة؛ أما ترتيب التشخيص وSLOs وبوابات النشر وسياسة التنبيه أدناه فتوصيات هندسية تم التحقق من مصادرها الأولية في 13 أكتوبر 2026.
ارسم مسار Lookup قبل أي تعديل
ابدأ بحالة فشل محددة: Workload وNamespace وNode والاسم المطلوب وRecord Type والوقت، وهل كانت النتيجة `NXDOMAIN` أو `SERVFAIL` أو Timeout أو نجاحًا بطيئًا. عبارة “DNS متوقف” تدمج أنظمة مختلفة. غياب Service Name داخل Namespace معينة يختلف عن Timeout في Upstream لخدمة عامة، وكلاهما يختلف عن Client يجرب كل Search Suffix مع كل طلب.
اختبر Fully Qualified Name مثل `payments.prod.svc.cluster.local`، ثم الاسم المؤهل بـNamespace مثل `payments.prod`، ولا تستخدم Short Name إلا عندما يشارك Caller الـNamespace. يوضح توثيق DNS للخدمات والـPods أن Short-name Resolution محصورة ضمن Namespace وأن kubelet يكتب إعداد DNS داخل Pod. سجّل Cluster Domain الفعلية ولا تفترض دائمًا أنها `cluster.local`.
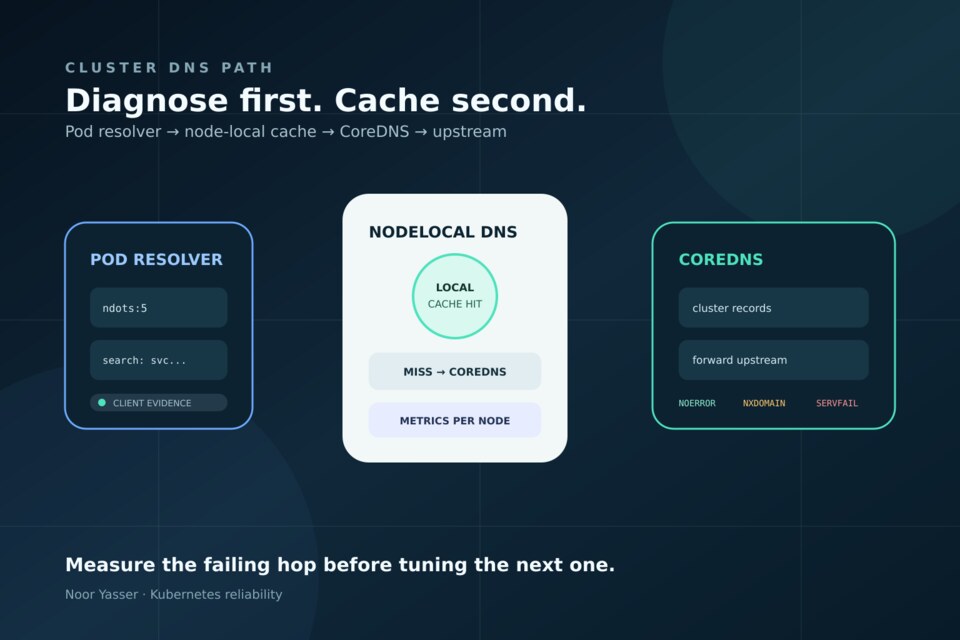
المسار الذي يجب قياسه هو:
Application Resolver
  → /etc/resolv.conf: search + ndots
  → kube-dns Service أو NodeLocal Address
  → CoreDNS / NodeLocal DNSCache
  → Kubernetes Plugin لأسماء Cluster
  → Forward Plugin للأسماء الخارجية
  → Upstream Resolver / Authoritative Server
كل تعديل في Hop يحتاج Hypothesis وMetric. زيادة CoreDNS Replicas لا تغيّر Search Expansion داخل Client، وخفض `ndots` لا يصلح EndpointSlice مفقودة، والـCache المحلية لا تحول `NXDOMAIN` صحيحة إلى سجل موجود.
شخّص من Pod إلى الخارج
أعد المشكلة من Debug Pod مؤقتة على Node وNamespace نفسيهما. يستخدم دليل Kubernetes الرسمي لتشخيص DNS أداة `dnsutils` ثم يفحص `/etc/resolv.conf` وDNS Pods وLogs وkube-dns Service وEndpointSlices. اتبع التسلسل لأنه يفصل Client Configuration عن Service Routing وعن سلوك الخادم.
kubectl exec -n prod deploy/api -- cat /etc/resolv.conf
kubectl exec -n prod deploy/api -- nslookup payments.prod.svc.cluster.local
kubectl -n kube-system get pods -l k8s-app=kube-dns -o wide
kubectl -n kube-system get svc kube-dns
kubectl -n kube-system get endpointslice -l kubernetes.io/service-name=kube-dns
kubectl -n kube-system logs -l k8s-app=kube-dns --tail=200
قارن Node تفشل بأخرى سليمة. إذا فشلت Node واحدة فقط، افحص NodeLocal DNS Pod وRouting وNetworkPolicy وconntrack قبل توسيع DNS على مستوى Cluster كلها. إذا فشلت أسماء Cluster على كل Nodes، افحص CoreDNS Health ووصوله إلى Kubernetes API و`kubernetes` plugin. وإذا فشلت الأسماء العامة فقط، افحص `forward` والـUpstream.
لا تترك Debug Container بصلاحيات واسعة دائمًا. استخدم أداة Incident محدودة، وسجّل الاسم المطلوب وResponse Code فقط بالقدر اللازم، ثم احذفها. لا تحتفظ بأسماء داخلية كاملة إلى الأبد إن كانت تكشف Tenant أو Service أو Environment.
اضبط Search Expansion وndots بوعي
يحتوي `/etc/resolv.conf` داخل Pod غالبًا على عدة Search Suffixes و`options ndots:5`. الاسم الذي يحتوي نقاطًا أقل من القيمة قد يجرب مع عدة Search Domains قبل الاسم المطلق. هذا مفيد لـService Discovery، لكنه قد يضخم DNS Traffic وTail Latency عندما تكرر التطبيقات حل أسماء خارجية أو Partially Qualified.
استخدم FQDN للخدمات الداخلية عند عبور Namespaces. وللخدمات الخارجية يمكن لاسم مطلق ينتهي بنقطة تجاوز Search Expansion عندما يدعم Resolver ذلك. لا تخفض `ndots` لكل Cluster كرد فعل؛ فقد تغيّر ترتيب Lookup وتكسر تطبيقات تعتمد على سلوك Kubernetes. اختبر `dnsConfig` على Workload محددة كـCanary وتحقق من الأسماء الداخلية والخارجية.
تحتاج Host-networked Pods إلى سياسة مقصودة. يوثق Kubernetes استخدام `ClusterFirstWithHostNet` مع `hostNetwork`. أما `dnsPolicy: None` فيحمّل Pod مسؤولية `nameservers` و`searches` و`options` كاملة، لذلك لا تستخدمه إلا لعزل DNS مقصود ومختبر.
قرر هل NodeLocal DNSCache تعالج السبب
NodeLocal DNSCache ميزة مستقرة تشغّل Caching Agent على كل Node. تتصل Pods بعنوان محلي، وتذهب Cache Misses إلى CoreDNS، ثم تتبع الأسماء الخارجية مسار Upstream. يذكر Kubernetes تقليل Cross-node Latency وiptables DNAT وضغط conntrack، وترقية الاتصالات من Local Agent إلى CoreDNS نحو TCP، وتوفير Metrics لكل Node وNegative Caching كدوافع للتصميم.
لذلك تناسب NodeLocal DNSCache الحالات التي تكرر فيها Pods الأسماء نفسها، أو تعبر DNS Packets بين Nodes، أو يقود UDP Loss وconntrack Saturation إلى Tail Latency، أو تحتاج الفرق دليلًا بحسب Node. لكنها ليست حلًا تلقائيًا لـUnique Names ذات Cache Reuse ضعيفة، ولا لـUpstream مكسورة أو Service Discovery خاطئة. كما تضيف DaemonSet واعتمادًا محليًا يجب مراقبته واختبار Rollback له.
يختلف التثبيت بحسب kube-proxy Mode. يوثق Kubernetes أن iptables Mode تستطيع الاستماع على kube-dns Service IP وNodeLocal Address، بينما تحتاج IPVS Mode إلى NodeLocal Address وتعديل kubelet `--cluster-dns`. اجعل هذه النقطة بوابة نشر: تحقق من Proxy Mode وعنوان محلي غير متعارض وسلوك IPv4 أو IPv6 وملكية مزود Kubernetes للإعداد قبل تغييره.
استخدم Cache دون التضحية بالحداثة
تحول Cache العمل المتكرر إلى Memory محلية واستجابة أسرع، لكنها تحتفظ أيضًا بنتائج النجاح والرفض مدة معينة. يوثق CoreDNS Cache Plugin Success وDenial Caches منفصلة وضبط Capacity وMaximum TTL. القيمة المحددة لا تمدد TTL أقصر مصدرية، بل تضع سقفًا فقط.
اشتق السياسة من معدل تغير السجلات وIncident Objectives، لا من رقم عام. تتغير Service Records أثناء Rollout وقد يفشل External Provider إلى عنوان آخر، وقد تظهر Negative Answer مؤقتًا وقت الإنشاء. رفع Minimum TTL قد يحتفظ ببيانات قديمة أو Denial أطول من المصدر، وتقليل Cache كثيرًا يعيد الحمل إلى Upstream.
قس Hits وMisses في كل طبقة. Hit Rate مرتفعة مع Latency مستمرة قد تشير إلى Client أو تطبيق لا CoreDNS. ارتفاع Denial Cache فجأة قد يعني Deployment يطلب اسمًا خاطئًا. أما Low Reuse مع Query Volume متصاعدة فيعني Unique Names؛ زيادة Cache Capacity لن تصلح هذا النمط.
وسّع CoreDNS حسب الطلب ومناطق الفشل
يبقى CoreDNS مصدر Service Discovery في Kubernetes حتى مع NodeLocal Cache أمامه. شغّل Replicas تكفي لفقد Node أو Zone مع خدمة Cache Misses والطلبات غير المخزنة. وزعها عبر Failure Domains، وضع CPU وMemory Requests واقعية، واجعل Readiness تعكس القدرة على الإجابة لا وجود Process فقط.
يوفر Kubernetes آلية رسمية لـDNS Horizontal Autoscaling. تساعد مع نمو Cluster، لكنها لا تعوض قياس QPS وResponse Codes وLatency وSaturation. كما أن التوسيع بعد Burst لا يحمي الموجة الأولى إن لم توجد Baseline Headroom وWarm Cache. اختبر فقد CoreDNS Replica وقت Peak متوقع.
لا تعدل Corefile دون Owner وRollback. يدعم دليل تخصيص DNS Stub Domains وUpstream Nameservers، لكن تغييرًا صحيح Syntax قد يصنع Loop أو Forwarding مفاجئًا أو Failure Domain أكبر. خزّن نسخة ConfigMap، واختبر خارج الإنتاج، وغيّر Replica واحدة تدريجيًا حيث يمكن، واحتفظ بآخر إعداد سليم.
عرّف DNS SLO وTelemetry قابلة للتنفيذ
قس Success Rate وLatency عند Client Boundary ثم أضف دليل الخادم. افصل أسماء Cluster عن External Names، وSuccess عن `NXDOMAIN` و`SERVFAIL`، وNodeLocal Hits عن Upstream Misses. راقب Request Rate حسب Record Type وResponse-code Ratio وDuration Percentiles وCache Hits/Evictions وForwarder Health وCoreDNS CPU Throttling وMemory وRestarts وتوفر NodeLocal وعدد kube-dns EndpointSlices.
SLO مفيدة تكون محددة: “99.95% من استعلامات أسماء Cluster المعتمدة تنجح خلال 50ms على نافذة خمس دقائق” قابلة للتشخيص، أما “DNS سليمة” فلا. القيمة هنا مثال ويجب اشتقاق الهدف من التطبيقات الفعلية. أنشئ Alert على أثر مستخدم مع سبب محتمل؛ Page لكل `NXDOMAIN` عابرة تصنع Noise لأن الرفض قد يكون مشروعًا. ارتفاع Timeouts أو `SERVFAIL` أو Latency مع Forwarder أو Saturation Signal أكثر فائدة.
شغّل Synthetic Lookup من Namespaces وNodes ممثلة، لكن لا تعتمد على اسم Cached واحد. اختبر Matrix صغيرة: Same-namespace Service وCross-namespace FQDN وKubernetes API Service وExternal Name معتمدة، وسجّل أي طبقة أجابت.
انشر التعديل وأثبت النتيجة
قبل التغيير سجّل Query Volume وp50/p95/p99 وTimeouts وResponse Codes وضغط conntrack وموارد CoreDNS. انشر NodeLocal DNSCache في Node Pool صغيرة أو Canary Cluster إن سمحت المنصة، وانقل Workload محدودة وتحقق من Resolver Configuration ثم قارن Matrix نفسها.
اختبر Normal Traffic وإنهاء CoreDNS Pod وUpstream Timeout وإنشاء Service جديدة وحذف Service وإعادة تشغيل NodeLocal Pod. عرّف Rollback مسبقًا: أعد kubelet Cluster DNS إن تغير، واحذف DaemonSet، وتأكد أن Pods تعود إلى kube-dns Service الأصلية. احتفظ بنسخ الإعداد وتوقيتها لفصل DNS Rollout عن Application Release.
القاعدة التنفيذية: أثبت Hop الفاشلة، واضبط تضخيم Client، وأضف Local Cache فقط عندما تستهدف Latency أو conntrack Pressure مقاسة، وأبقِ CoreDNS متكررة، واختبر Positive وNegative Answers أثناء الفشل. تأتي موثوقية DNS من Dependency Chain قابلة للمراقبة، لا من Cache أكبر وحدها.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
- Kubernetes — DNS for Services and Pods, verified 13 October 2026
- Kubernetes — Debugging DNS Resolution, verified 13 October 2026
- Kubernetes — Using NodeLocal DNSCache, verified 13 October 2026
- Kubernetes — Autoscale the DNS Service, verified 13 October 2026
- Kubernetes — Customizing DNS Service, verified 13 October 2026
- CoreDNS — Cache plugin, verified 13 October 2026
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.