الإغلاق السليم في Kubernetes ليس أمر sleep يوضع داخل YAML؛ بل تنسيق موزع بين التطبيق وkubelet وService وEndpointSlice وLoad Balancer وعميل قد يحتفظ باتصال قديم. التصميم الموثوق يوقف استقبال عمل جديد، ويمنح التوجيه وقتًا للتقارب، وينهي الطلبات الجارية، ويغلق المستهلكين والاتصالات، ثم يخرج قبل انتهاء مهلة Pod. يجب أن يعالج التطبيق SIGTERM بنفسه؛ فلا تستطيع Kubernetes إكمال معاملة أو تأكيد رسالة بدلًا عنه. أما PodDisruptionBudget فيحد الاضطرابات الطوعية المتزامنة، لكنه لا يمنع عطل Node ولا يدير RollingUpdate. لذلك قد يظهر النشر ناجحًا في Controller بينما يرى المستخدم Connection Reset أو يتكرر Job أو يصل Container إلى SIGKILL.
توضح وثائق Kubernetes أن عداد terminationGracePeriodSeconds يبدأ قبل تشغيل preStop، ثم يرسل Runtime إشارة TERM بعد اكتمال Hook، بالتوازي مع تحديث مسار Service. المهلة الافتراضية 30 ثانية، وبعد انتهائها يُقتل ما بقي بالقوة. وتعرض EndpointSlice حالات terminating وserving وready حتى تميز طبقات التوجيه بين Endpoint يغادر الخدمة وآخر ما زال صالحًا. ابنِ العقد على هذه الحالات القابلة للرصد، لا على افتراض ترتيب مثالي بين كل Proxy والتطبيق.
اجعل الإغلاق عقدًا داخل التطبيق
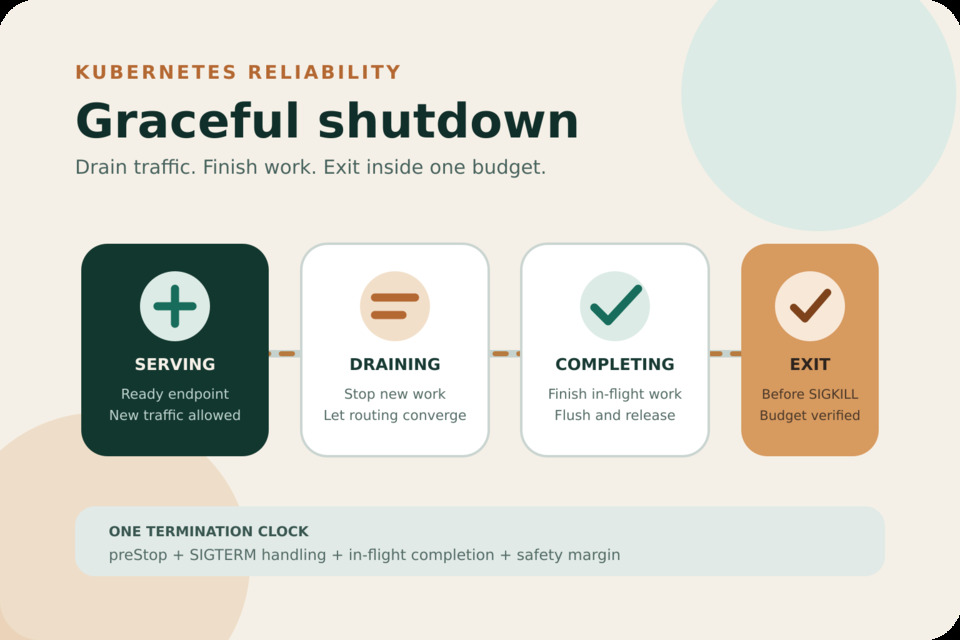
عرّف الإغلاق كـState Machine لها شروط واضحة:
1. تنتقل النسخة من accepting إلى draining مرة واحدة فقط. 2. ترفض العمل الطويل الجديد أو تعيد توجيهه بعد بدء Drain. 3. كل عمل جرى قبوله يُكمل أو يحرر Lease أو يصبح آمنًا لإعادة المحاولة. 4. لا يخرج Process بنجاح إلا بعد وصول Listeners وWorkers والكتابات الدائمة إلى حالة معروفة. 5. لكل خطوة Deadline أقصر من الوقت المتبقي في Grace Period.
تختلف الدلالة حسب Workload. HTTP API يوقف قبول الاتصالات وينتظر Active Requests. مستهلك Queue يوقف Polling قبل انتظار Handlers. خدمة WebSocket ترسل تعليمات Reconnect وتحدد نافذة إغلاق. القائد يحرر Lease أو يسمح بانتهائها. لا تخفِ هذه العقود المختلفة وراء Delay عامة.
اجعل Shutdown Path قابلة للتكرار بلا أثر إضافي. قد تتداخل Signals وHooks وCallbacks، كما أن Lifecycle Hooks مصممة بتسليم at-least-once وقد تتكرر نادرًا. الاستدعاء الثاني يجب أن يرى Drain القائمة، لا أن يبدأ Flush ثانية أو يؤكد الرسالة مرتين.
افهم Timeline الحقيقي للإنهاء
عندما تحصل Pod على deletionTimestamp تبدأ عمليات متقاربة زمنيًا، لا سلسلة مثالية صارمة. يبدأ kubelet الإغلاق المحلي. إن وجد preStop ينفذه قبل إرسال TERM إلى العملية الرئيسية. وفي الوقت نفسه يبدأ Control Plane بوضع Pod في حالة إنهاء بالنسبة إلى Workload وService Routing.
يبدأ العداد قبل preStop. إذا كانت الميزانية 60 ثانية واستهلك Hook مقدار 15 ثانية، فلن يحصل التطبيق على 60 ثانية جديدة بعد SIGTERM؛ يبقى له نحو 45 ثانية. توثق Kubernetes تمديدًا طارئًا صغيرًا من ثانيتين عندما يستمر Hook بعد انتهاء المهلة، لكن لا تبنِ إنتاجك على هذا الهامش.
تبقي EndpointSlice الطرف المنتهي مع ready=false للتوافق. تتجاهله معظم Service Proxies في المرور العادي، لكن قد تستخدم طبقة التوجيه Endpoint تجمع serving وterminating إذا أصبحت كل الأطراف في حالة إنهاء. وقد تختلف سرعة تقارب External Load Balancer وIngress وService Mesh وDNS Cache وKeep-Alive Connections. إزالة الطرف من التوجيه العادي ضرورية، لكنها ليست برهانًا أن Packet جديدة لن تصل.
اجعل Process يمتلك Graceful Shutdown
سجّل Signal Handler قبل إعلان Readiness. الترتيب العملي هو:
- فعّل draining flag واجعل Readiness تفشل؛ - أوقف قبول Connections أو Queue Messages جديدة؛ - اطلب من العملاء طويلي الاتصال إعادة الاتصال إن كان البروتوكول يدعم ذلك؛ - انتظر العمل الجاري إلى Deadline محددة؛ - حرر Leases ونفّذ Flush للقياسات وأغلق Database Clients؛ - اخرج بكود يميز الاكتمال النظيف عن Timeout.
يجب أن تستقبل Process 1 داخل Container الإشارة وتمررها. Shell Wrapper لا تستخدم exec، أو Child Processes منفصلة، أو Supervisor سيئ قد يبتلع SIGTERM أو يؤخرها. اختبر Image المبنية نفسها، لا Development Server فقط. وإذا استخدمت Native Sidecars، تؤخر Kubernetes إنهاءها حتى تخرج Main Containers ثم توقفها بعكس ترتيب تعريفها؛ وهذا أوثق من Scripts طويلة لترتيب الإغلاق.
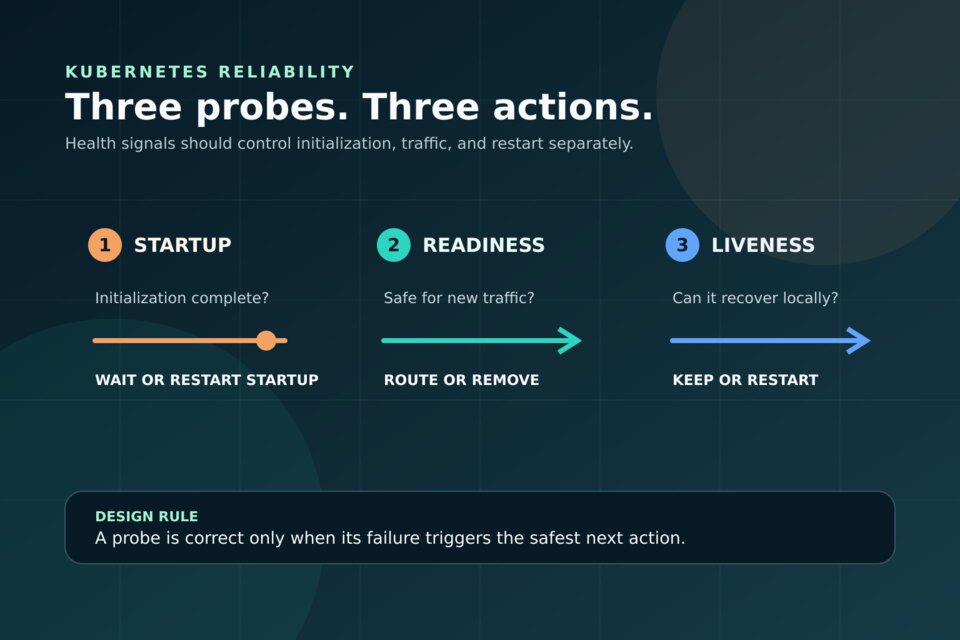
Readiness إشارة لقبول المرور وليست منفذ الإغلاق. تخبر Services هل تستقبل Pod المرور العادي. اجعل Endpoint خفيفة ومحلية بما يكفي لتعمل أثناء Incident في Dependency. يستطيع Handler جعلها false فورًا، لكنه ما يزال ملزمًا بإغلاق Listener وانتظار العمل؛ فالConnections القائمة لا تختفي بتغير Readiness.
استخدم preStop كنافذة تقارب قصيرة
تفيد preStop عندما لا يستطيع Process معرفة حذف Pod قبل SIGTERM، أو عندما تحتاج طبقات التوجيه فترة قصيرة للانتشار. اجعلها قصيرة وحتمية. زمنها محسوب من terminationGracePeriodSeconds، ولا تصل TERM قبل انتهائها. Sleep مدتها 25 ثانية ضمن ميزانية 30 ثانية قد تترك ثواني قليلة فقط لتنظيف التطبيق.
فضّل Signal Handling داخل التطبيق لتنظيف Business State. Hook تستدعي Admin Endpoint غير محمي، أو تعتمد على DNS، أو تشغل Shell Program كبيرًا تضيف مسار فشل في لحظة حساسة. إذا حفظت Hook حالة فاجعلها Idempotent واحسب Worst-case Latency. وإذا كان هدفها انتظار Routing Convergence فقط، فسجّل قيمة الانتظار واختبرها من قياسات Endpoint وLoad Balancer بدل نسخ رقم اعتباطي.
احسب Grace Budget واحدة وصريحة
اختر المهلة من مكونات مقاسة:
grace >= preStop propagation buffer + أطول Request أو Job Slice مقبولة + زمن إغلاق الاتصالات والعملاء + زمن Flush دائم أو تحرير Lease + Safety Margin
لا تستخدم Average Latency. استخدم High Percentile وProduct Deadline وعقد Retry. إن كنت تسمح لطلب بالعمل دقيقتين فلن تجعل مهلة 30 ثانية إغلاقه سليمًا. قصّر Request Deadline، أو اجعل العمل Resumable، أو انقل Ownership، أو زد الميزانية.
للمهلة الطويلة تكلفة. تبقى Pods المنتهية مستهلكة CPU وMemory وConnections، وقد يستخدم Deployment موارد أكثر من replicas + maxSurge مؤقتًا لأن Terminating Pods لا تُحسب Available Replicas. الحل ليس دائمًا رقمًا أكبر؛ أحيانًا يلزم تقسيم العمل إلى وحدات محدودة وCheckpoint أسرع.
اعرف ما الذي تحميه PDB فعلًا
تحد PDB عدد Replicas غير المتاحة في الوقت نفسه بسبب Voluntary Disruptions التي تستخدم Eviction API. يحترمها kubectl drain ويعيد محاولة Evictions المرفوضة. وهي مناسبة لصيانة Node المخطط لها وترقية Cluster والعملاء المتعاونين مع Eviction.
ليست PDB درعًا من Involuntary Failure. فقدان Hardware أو Kernel أو Network قد يزيل السعة؛ وتُحسب Pods المفقودة ضد Budget لكنها لم تُمنع. ويمكن للحذف المباشر تجاوز سياسة Eviction. كما تضبط Deployment وStatefulSet تحديثاتها باستراتيجية Rollout الخاصة، لا بقيود PDB، مع أن Pods غير المتاحة أثناء Rollout تؤثر في Budget التي تراها Evictions أخرى.
اختر السياسة من قدرة الخدمة:
| Workload | نقطة بداية مفيدة | الخطر الأساسي | | --- | --- | --- | | API عديمة الحالة بأربع Replicas | minAvailable: 3 أو maxUnavailable: 1 | يجب أن تتحمل النسخ الباقية Peak Load | | نظام Quorum بخمسة أعضاء | minAvailable حسب Quorum مع هامش إصلاح | العدد الصحي لا يساوي دائمًا Membership آمنة | | نسخة واحدة | لا تصنع PDB توفرًا؛ minAvailable: 1 تمنع Voluntary Eviction | قد تتوقف الصيانة دون نافذة Downtime | | Pods معطلة تمنع Drain | فكّر في unhealthyPodEvictionPolicy: AlwaysAllow | لا تنتظر صحة لن تعود |
تحقق أن Selector تطابق Controller المقصودة تمامًا. راقب status.currentHealthy وdesiredHealthy وdisruptionsAllowed قبل الصيانة. Policy لا تختار شيئًا، أو تختار Version Label خاطئة، أو تجمع Workloads مستقلة تعطي إحساس أمان كاذبًا.
نسّق Deployment Capacity مع Drain
في RollingUpdate يحدد maxUnavailable مقدار Serving Capacity التي يمكن فقدها، ويحدد maxSurge السعة المؤقتة للاستبدال. تمنع minReadySeconds نسخة أصبحت Ready للحظات من أن تُحسب Available مباشرة. وتبلغ progressDeadlineSeconds عن Rollout عالقة لكنها لا تنفذ Rollback تلقائيًا.
يجب أن تشمل Capacity Math النسخ المنتهية. تخيل API لها أربع Replicas وmaxUnavailable=0 وmaxSurge=1 وGrace Period تساوي 45 ثانية. يجب أن تصبح Pod الجديدة Ready قبل بدء إنهاء القديمة، لكن القديمة قد تستهلك الموارد 45 ثانية إضافية. وفر سعة للنسخة الجديدة والعمل القديم وConnection Pools والمرور الذي انتقل إلى النسخ الباقية.
استخدم Topology Spread أو Anti-affinity حتى لا يزيل Drain واحد معظم النسخ. وتأكد أن HPA minimum replicas وPDB وRollout Strategy تصف أهداف توفر متوافقة. لا تعالج PDB صارمة وضع كل النسخ على Node واحدة، ولا ينفع Shutdown Handler ممتاز عندما لا يملك Scheduler مكانًا للاستبدال.
Manifest أقرب إلى الإنتاج
يحجز المثال نافذة قصيرة لتقارب التوجيه ويترك معظم المهلة للتطبيق بعد SIGTERM:
~~~yaml apiVersion: apps/v1 kind: Deployment metadata: name: orders-api spec: replicas: 4 minReadySeconds: 10 progressDeadlineSeconds: 300 strategy: type: RollingUpdate rollingUpdate: maxUnavailable: 0 maxSurge: 1 template: spec: terminationGracePeriodSeconds: 45 containers: - name: api image: registry.example/orders-api:2026-10-18 ports: - name: http containerPort: 8080 readinessProbe: httpGet: path: /ready port: http periodSeconds: 3 timeoutSeconds: 1 failureThreshold: 2 lifecycle: preStop: exec: command: ["/bin/sh", "-c", "sleep 5"] --- apiVersion: policy/v1 kind: PodDisruptionBudget metadata: name: orders-api spec: minAvailable: 3 unhealthyPodEvictionPolicy: AlwaysAllow selector: matchLabels: app: orders-api ~~~
يجب أن تحتوي Image فعلًا على shell وأمر sleep لهذا Exec Hook. غالبًا لا تحتوي Distroless Image عليهما؛ استخدم Sleep Hook المدعومة في Cluster المتوافقة أو نفذ مرحلة الانتشار داخل التطبيق. لا تجعل Manifest الإغلاق موثوقًا وحدها؛ ما يزال Process يحتاج SIGTERM محددة بزمن، وعملًا آمنًا للإعادة، وسعة كافية.
راقب الإغلاق كعملية مستقلة
أصدر shutdown_started مع Pod Identity والسبب إن توفر والDeadline المتبقية. راقب in_flight_requests وactive_jobs وgraceful_shutdown_duration_seconds وforced_shutdown_total وrejected_during_drain_total وConnection Resets. اربطها بـDeployment Revision وحالة PDB وشروط EndpointSlice وأحداث Node Drain.
أنشئ Alert على Pods تقضي معظم المهلة في Terminating، وتكرار Exit Code 137 ضمن سياق إنهاء، وDrain متوقفة بسبب disruptionsAllowed=0، وارتفاع 5xx أثناء Rollout، وReplacements لا تتجاوز minReadySeconds. الكود 137 وحده ملتبس لأن SIGKILL وMemory Pressure قد ينتجانه؛ اجمع Container State وReason وkubelet Events وMemory Metrics.
اختبر الفشل قبل الثقة بالعقد
أرسل Requests تمتد عبر Grace Window، وابدأ Rollout، وتأكد أن Responses المقبولة تكتمل بلا Reset. نفذ Drain على Node تحت Load وتأكد أن PDB تمنع Eviction ثانية متزامنة. اجعل Pod واحدة Unhealthy واختبر أن Unhealthy Eviction Policy المختارة تسمح للصيانة بالتقدم. وتجاوز Cleanup Deadline عمدًا حتى يظهر Timeout بوضوح بدل فشل صامت.
اختبر أيضًا ما لا تمنعه PDB: أوقف Node، واقطع Network، واستنزف Replacement Capacity. في Workers اقتل Process بعد استلام Message وقبل Acknowledgement، وأثبت أن Job تعاد بلا Duplicate Side Effects. وفي WebSocket راقب توزيع Reconnect حتى لا يصنع آلاف العملاء Reconnect Storm متزامنة.
Anti-patterns والحدود
استخدام sleep في preStop بلا قياس للانتشار Cargo Cult. جعل Readiness false دون إدارة Connections القائمة يهجر العمل. الاعتماد على PDB أثناء Deployment Rollout يخلط حدود Controllers. Force Delete في الصيانة اليومية يتجاوز Grace Contract. ومهلة طويلة جدًا لكل Workload قد تعطل العمليات وتفرط في استهلاك Nodes.
لا تضمن Kubernetes Exactly-once Processing أو سلوك Client خارجي أو تعافي Database Transaction. استخدم Idempotency Keys وLeases وCheckpoints وDurable Queues لصحة العمل. واستخدم Request Deadlines وRetry Budgets حتى يعرف العميل متى تعاد المحاولة بأمان. أما Singleton لا يتحمل Overlap أو Absence فيحتاج Leadership وFencing صريحين؛ اسم Pod ليس قفلًا موزعًا.
قائمة الإنتاج
عالج SIGTERM في Process 1 واختبر Image المبنية. أوقف العمل الجديد قبل انتظار الجاري. اجعل Cleanup قابلة للتكرار ومدركة للDeadline. اجعل preStop قصيرة واحسبها ضمن ميزانية واحدة. قس Routing Convergence وRequest Duration. اضبط Deployment Availability وSurge Capacity باستقلال عن PDB. استخدم Eviction API للصيانة وافحص PDB قبل Drain. وزع Replicas عبر Failure Domains. اختبر الإنهاء السليم والفشل القسري تحت Load. ينجح Shutdown فقط عندما لا يرى المستخدم أخطاء غير مفسرة ويبقى العمل المقبول صحيحًا.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
- Kubernetes — Pod termination flow, verified 18 October 2026
- Kubernetes — Container lifecycle hooks and preStop guarantees, verified 18 October 2026
- Kubernetes — Readiness probes and Service traffic, verified 18 October 2026
- Kubernetes — EndpointSlice serving, terminating and ready conditions, verified 18 October 2026
- Kubernetes — Pod disruptions and PodDisruptionBudget semantics, verified 18 October 2026
- Kubernetes — Safely drain a node, verified 18 October 2026
- Kubernetes — Deployment rolling update and terminating replica behavior, verified 18 October 2026
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.