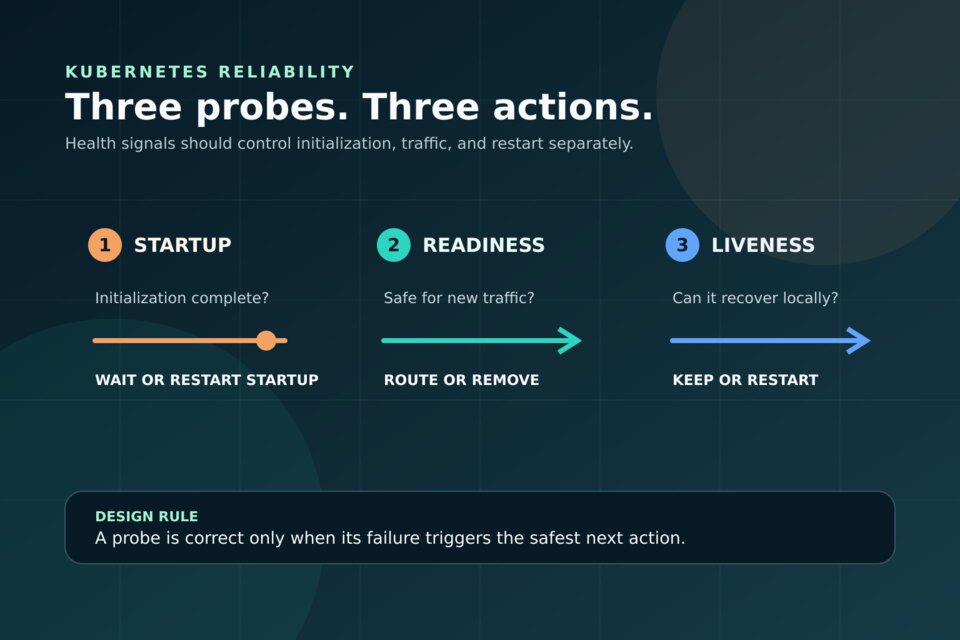
إن Kubernetes Probes الموثوقة ثلاثة عقود تحكم مختلفة، وليست ثلاث نسخ من Health Endpoint واحدة. تحدد `startupProbe` هل اكتمل التهيئة، وتحدد `readinessProbe` هل يجب أن تستقبل Pod حركة Service، وتحدد `livenessProbe` هل إعادة تشغيل Container أرجح في إصلاحها من إبقائها تعمل. تأتي موثوقية الإنتاج من فصل هذه الأسئلة، واستخراج التوقيت من قياسات فعلية لتوزيع الإقلاع والتعافي، وجعل Handlers رخيصة ومحلية، وربط الجاهزية بسياسة الإطلاق والسعة. يهم ذلك للـAPIs والWorkers والGateways والخدمات ذات الحالة، لأن فشلًا كاذبًا قد يحول عطل Dependency صغيرًا إلى Restart Storm على مستوى الأسطول.
توثق إرشادات Kubernetes الرسمية للفحوص الآلية بوضوح: فشل الجاهزية يزيل Pod من حركة Kubernetes Service، وفشل الحيوية يعيد تشغيل Container، وStartup Probe تؤجل فحوص الحيوية والجاهزية حتى تنجح البداية. هذه حقائق عن المنصة. أما حدود Endpoints وطريقة ضبط التوقيت وسياسة الاعتماديات وبوابات Rollout أدناه فهي إرشاد هندسي لتحويل هذه الآلية إلى عقد إنتاج يمكن الاعتماد عليه.
ابدأ من فعل الاسترداد
قبل كتابة Endpoint اسأل: ماذا سيفعل Kubernetes عند الفشل؟ إذا كان الرد المطلوب “انتظر، فالتهيئة ما زالت تتقدم”، فالإشارة تخص Startup. وإذا كان “أوقف توجيه الطلبات الجديدة مع إبقاء العملية حية لتتعافى”، فهي تخص Readiness. وإذا كان “العملية لا تستطيع التقدم، وإعادة التشغيل النظيفة أفضل إصلاح محلي”، فهي تخص Liveness. أما الإشارة التي لا يملك النظام لها فعلًا آليًا آمنًا فيجب أن تكون Metric أو Alert لا شرط Liveness.
تمنع هذه القاعدة خطأ شائعًا: اعتبار كل مشكلة في Dependency دليلًا على موت Process. قد يؤدي انقطاع قاعدة البيانات أو Rate Limit من مزود خارجي أو غياب Cache إلى فشل بعض الطلبات، لكن إعادة تشغيل كل Replicas لا تصلح الاعتماد. بل تهدم Caches الدافئة، وتولد موجات اتصال جديدة، وتزيل سعة كانت ما تزال نافعة. يجب أن تثبت Liveness التقدم المحلي لا صحة الإنترنت كله.
اجعل لكل Probe سؤالًا واحدًا ضيقًا
يجيب Startup Endpoint هل وصلت التهيئة لموضع يصبح فيه تقييم الصحة العادي ذا معنى. من أمثلته تحميل إعداد ضروري، أو Replay محدود لسجل، أو تسخين Index أساسي داخل الذاكرة، أو بدء Request Loop. لا تنتظر أعمالًا خلفية اختيارية تستطيع الاستمرار بعد بدء الخدمة.
يجيب Readiness Endpoint هل تستطيع هذه Replica قبول عمل جديد الآن. يمكنه تضمين إشارات Admission محلية، مثل تشبع Queue، أو نفاد Worker Pool، أو Circuit Breaker يجعل كل العمليات المدعومة مستحيلة، أو Configuration Generation لم يطبق بعد. يجب أن يفشل قبل أن يتحول الضغط إلى انهيار، ولكن فقط إذا كان إخراج Pod من الحركة يترك سعة جاهزة كافية في بقية Replicas.
يجيب Liveness Endpoint هل تستطيع العملية التعافي دون Restart. الفحوص المفيدة محلية: تقدم Event Loop، أو Heartbeat لعامل داخلي ضروري، أو Deadlock Detector موثوق، أو فساد حالة داخل الذاكرة لا يمكن إصلاحها. أعِد النجاح عندما تكون العملية Degraded لكنها قادرة على التعافي. إعادة التشغيل State Transition مدمرة، ولذلك تحتاج دليلًا قويًا.
لا تضع الاعتماديات المشتركة داخل Liveness
استدعاء قاعدة البيانات الأساسية أو Payment API خارجي أو DNS أو Message Broker مشترك من Liveness يربط سياسة إعادة تشغيل كل Replica بالاعتماد نفسه. عند عطل مشترك قد تفشل كل Pods معًا، وتعيد التشغيل معًا، ثم تعيد الاتصال معًا. وهكذا يتزامن الحمل في اللحظة التي تكون فيها سعة الاعتماد أضعف، ويصنع Repair Mechanism عطلًا متسلسلًا.
تحتاج Readiness قرارًا أدق. إذا كان التطبيق عاجزًا فعلًا عن تقديم أي طلب صحيح دون Dependency، فقد يكون إخراج Replica من الحركة مناسبًا. أما إذا استطاع خدمة Cached Reads أو Static Routes أو Fallbacks أو طلبات لا ترتبط بالاعتماد المعطّل، فأبقِ Pod جاهزة واعرض Degradation على مستوى Route أو Capability. في APIs المختلطة تكون Readiness Bit واحدة خشنة غالبًا؛ استخدم Application Admission وCircuit Breakers ومعالجة أخطاء خاصة بكل Endpoint.
لا تجعل Probe تستخدم Worker Pool المشبع نفسه الذي يفترض أن تشخصه. احجز Execution Path صغيرًا، وتجنب Locks غير المحدودة، واضبط كل عملية داخلية بحد زمني. يجب ألا يكتب Handler بيانات أو يحدث Tokens أو ينفذ Migrations أو يسخن Cache أو يطلق Recovery Jobs. مراقبة الصحة لا ينبغي أن تغير حالة العمل.
استخرج نافذة Startup من القياس لا التمني
توصي Kubernetes بحساب نافذة Startup عبر `failureThreshold * periodSeconds` بحيث تغطي أسوأ زمن إقلاع متوقع. هذه Budget وليست Delay عشوائية. قس Cold Starts حسب Image Version وNode Class وحجم Dataset ونمط الإعداد. اختر Percentile وهامش أمان يعكسان SLO، ثم نبّه عندما يقترب الإقلاع من الحد بدل زيادته إلى الأبد.
مثلًا، إذا كانت Cold Starts المشروعة أقل من 110 ثوانٍ عند Percentile المختار، والفريق يسمح بهامش 30 ثانية، فإن Period قدرها 10 ثوانٍ و`failureThreshold: 14` تنشئ نافذة 140 ثانية. بعد نجاح Startup تستطيع Liveness استخدام ميزانية كشف أقصر كثيرًا. وإذا لم تنجح البداية مطلقًا يعيد Kubernetes التشغيل وفق `restartPolicy`. سجّل سبب عدم اكتمال التهيئة حتى يفرق المشغل بين تقدم بطيء وخطأ إعداد دائم.
هذا مثال توضيحي:
startupProbe:
  httpGet: { path: /startupz, port: health }
  periodSeconds: 10
  timeoutSeconds: 2
  failureThreshold: 14
livenessProbe:
  httpGet: { path: /livez, port: health }
  periodSeconds: 10
  timeoutSeconds: 2
  failureThreshold: 3
readinessProbe:
  httpGet: { path: /readyz, port: health }
  periodSeconds: 5
  timeoutSeconds: 2
  failureThreshold: 2
  successThreshold: 2
هذه القيم أمثلة وليست Defaults عامة. تعتمد الميزانية المناسبة على Scheduler Delay وCPU Limits وRuntime Pauses وRequest Concurrency وسلوك الاعتماديات ونموذج تعافي التطبيق.
افهم حساب التوقيت الكامل
توثق Kubernetes Pod API أن `timeoutSeconds` الافتراضية ثانية واحدة، و`periodSeconds` عشر ثوانٍ، و`failureThreshold` ثلاثًا، و`successThreshold` واحدة. ويجب أن تكون Success Threshold واحدة في Liveness وStartup، بينما تستطيع Readiness طلب نجاحات متتالية لتقليل Flapping بعد الفشل. اضبط كل حقل توقيت صراحة حتى لا يكشف تغيير Runtime أو Cluster افتراضًا عرضيًا.
زمن الكشف التقريبي ليس `periodSeconds * failureThreshold` فقط. أضف زمن الانتظار حتى Probe التالية، وكل Timeout، ومعالجة Kubelet، وTermination Grace، وتوقف Container وRestart Backoff. وفي Readiness أضف انتشار EndpointSlice وسلوك Load Balancer خارج Kubernetes. قس زمن الإزالة والعودة كما يراه Client بدل اعتبار أرقام YAML ميزانية العطل كاملة.
اضبط `timeoutSeconds` فوق High Percentile لـHandler سليم، ولكن تحت المدة التي لا قيمة للانتظار بعدها. قد تكون الثانية الافتراضية صارمة مع Process يمر بوقفة Runtime قصيرة، بينما Timeout كبيرة تؤخر الكشف وتستهلك عمل Kubelet. العلاج الأفضل لـHealth Endpoint بطيئة هو جعلها أرخص عادة، لا إعطاؤها Network-scale Timeout.
امنع Readiness Flapping من التحول إلى Overload
Readiness حلقة تحكم للحركة. إذا أعلنت Pods أنها Unready عند أول ضغط، تتركز الحركة على البقية، ثم تصبح البقية Unready كذلك. تختفي السعة على مراحل، ويستقبل Rollout أو Autoscaler إشارة مضللة. صمم Admission مع Hysteresis: افشل بعد عجز مستمر عن قبول العمل، وتعاف بعد نجاحات متعددة أو Threshold تعافٍ أقل.
احتفظ بـHeadroom يكفي كي لا يؤدي إخراج Pod واحدة إلى تحميل البقية فوق قدرتها. اختبر Readiness مع Replica Count و`maxUnavailable` وTopology Spread وAutoscaling Lag وDisruption Budgets. Probe آمنة مع 30 Replica قد تكون خطرة مع اثنتين. دور Readiness عزل Replica سيئة، لا تنفيذ Load Shedding عالمي بالمصادفة.
في Queue Consumer لا يستقبل Service Traffic، قد تفيد Readiness للControllers أو Dashboards، لكنها ليست بديلًا عن إيقاف Consumption. استخدم Application Lease أو Broker Flow Control أو Graceful Shutdown لملكية العمل. طابق الإشارة مع مسار الحركة الحقيقي.
اربط Probes بتقدم Deployment
أن تصبح Pod جاهزة مرة لا يعني أن الإصدار مستقر. توفر Kubernetes Deployments الحقل `minReadySeconds`، وهو المدة التي يجب أن تبقى فيها Pod الجديدة Ready دون Crash قبل اعتبارها Available. قيمته الافتراضية صفر. اضبطه ليغطي نافذة الفشل المبكر المهمة لديك، حتى لا تدفع إشارة خضراء لحظية Rollout إلى الأمام فورًا.
وتوفر Deployments أيضًا `progressDeadlineSeconds`، وقيمتها الافتراضية 600 ثانية ويجب أن تكون أكبر من `minReadySeconds`. يبلغ Kubernetes عن `ProgressDeadlineExceeded` عندما يتوقف التقدم، لكن Deployment Controller يبلغ الحالة فقط ولا ينفذ Rollback تلقائيًا. يجب أن يراقب CI/CD أو Higher-level Controller هذه الحالة ويطبق سياسة الإصدار.
ابنِ Rollout Gate من Stable Availability وError Rate وLatency ودليل Restarts. نجاح Readiness ضروري لكنه غير كافٍ. أبقِ ReplicaSet السابقة قابلة للنشر، وحدد من أو ما يبدأ Rollback، واختبر المسار قبل إصدار خطر.
استخدم Readiness Gates لحقائق دورة حياة خارجية فقط
تدعم Kubernetes الحقل `readinessGates` لشروط إضافية في Pod Status. لا تصبح Pod جاهزة إلا عندما تكون كل Containers جاهزة وكل الشروط المحددة True، والشرط المفقود يعد False. يفيد ذلك عندما يملك Operator أو Controller حقيقة لا يستطيع HTTP Handler داخل Container معرفتها، مثل تسجيل External Load Balancer أو اكتمال Platform Attachment.
لا تستخدم Readiness Gates كطريقة عامة للاتصال البعيد. يحتاج Controller الذي يكتب الشرط Ownership وRBAC وRetries ومعالجة Staleness ومراقبة. عرّف من يمسح الشرط وماذا يحدث عند تعطل Controller؛ وإلا تصبح Gate نقطة مفردة جديدة تبقي Rollout كاملًا Unready.
اختر HTTP أو TCP أو Exec أو gRPC بقصد
تنقل HTTP Probe حالة على مستوى التطبيق، وهي الأسهل غالبًا في Versioning والمراقبة. تثبت TCP أن Socket تقبل الاتصال فقط؛ وقد يستمر Server عالق في القبول. تستطيع Exec فحص حالة محلية لكنها تضيف Process Creation وقد تعتمد على Shell أو Utility غير موجودة في Minimal Image. وتستخدم gRPC Probe الأصلية بروتوكول الصحة القياسي، لكن لها سلوك Port وTimeout يجب اختباره على Cluster Version المستخدمة.
طابق البروتوكول مع السؤال. قد تكفي TCP Liveness لـProxy بسيط حالته الوحيدة المفيدة هي Listener، بينما يحتاج API معقد دلالة صحة صريحة. لا تجعل نجاح Probe يمر عبر Authentication Middleware أو Tenant Lookup أو Rate Limits المخصصة لحركة المستخدم. احمِ Health Port عبر Network Policy أو Node-local Reachability بدل Login هش.
راقب حلقة التحكم
صدّر Handler Latency والنتيجة حسب نوع Probe دون Labels عالية Cardinality. تتبع Readiness Transitions وRestart Count وآخر Termination Reason وStartup Duration والزمن حتى Stable Availability وتقدم Rollout. اربط الفشل بـCPU Throttling وMemory Pressure وRuntime Pauses وNode Events وحوادث الاعتماديات. نبّه على الأنماط: فشل Liveness متزامن عبر Replicas، وتذبذب Readiness، واقتراب Startup من مهلتها، وإصدارات تتجاوز Progress Deadline.
سجّل تفاصيل تكفي للتشخيص، لكن أعد لـKubelet استجابة صغيرة فقط. لا تعرض Credentials أو Connection Strings أو Stack Traces أو Dependency Topology أو Customer Data من Health Endpoint بلا Authentication. واجهة Diagnostics الداخلية وعقد Probe واجهتان مختلفتان.
اختبر Failure Injection قبل الإنتاج: جمّد Request Loop، واستنفد Worker Pool، واقطع قاعدة البيانات، وأخّر DNS، واجعل Handler يتجاوز Timeout، وأفسد حالة محلية ضرورية، وأنهِ Container أثناء Rollout. تحقق من الفعل الدقيق الذي تسببه كل Probe، ومن سلوك الحركة كما يراه Client، وهل يتعافى الأسطول دون Restarts متزامنة.
دليل القرار
استخدم Startup عندما تملك Process مرحلة تهيئة مشروعة أطول أو أكثر تغيرًا من زمن كشف Liveness المطلوب. استخدم Readiness عندما يجب أن تخرج Replica مؤقتًا من توجيه الطلبات الجديدة مع بقائها حية. استخدم Liveness فقط عندما تكون إعادة التشغيل إصلاحًا محليًا مثبتًا. استخدم Readiness Gate عندما يملك Controller خارجي حقيقة منصة ضرورية. استخدم Metrics وAlerts عندما يجب أن يقرر بشر أو نظام أعلى. واستخدم Route-level Degradation عندما يعتمد جزء واحد فقط من المنتج على المكوّن الفاشل.
تجنب Liveness لقواعد البيانات أو APIs بعيدة، وReadiness تفحص كل الاعتماديات تكراريًا، وProbe Handlers خلف Busy Request Pool، وEndpoint واحدة بدلالات متطابقة، وDefault Timeouts غير مفهومة، وافتراض Rollback تلقائي. لا تنسخ Probe Timings من خدمة أخرى؛ استخرجها من سلوك هذه الخدمة ونموذج سعتها.
القيود
لا تثبت Probes صحة العمل. قد تكون Process Live وReady بينما تعيد بيانات خاطئة أو تكسر Authorization أو تسقط Messages. وهي لا تستبدل Synthetic Transactions أو SLO Monitoring أو Tracing أو Dependency Health أو Graceful Shutdown أو Release Verification. يراقب Kubernetes Replica واحدة من Node؛ والدليل End-to-end وحده يثبت أن المنتج يعمل للمستخدمين.
تبادل Probes العدوانية سرعة الإصلاح المحلي مقابل False Positives أكثر. وتقلل Probes المحافظة Restarts الخاطئة لكنها تطيل بقاء Process ميتة. لا يوجد Interval عالمي. اختر المقايضة من Error Budgets وRedundancy وتكلفة التعافي والتوزيعات المقاسة، ثم راجعها عند تغير الحركة أو Runtime.
قائمة تنفيذية
عرّف فعل استرداد واحدًا لكل إشارة. اجعل Liveness محلية وجديرة بالRestart. اجعل Readiness مرتبطة بالقدرة ومدركة للسعة. احسب Startup من دليل Cold Start. اضبط Timeouts وPeriods وThresholds صراحة. اربط Readiness بـReplica Headroom وإعدادات Rollout والمراقبة. استخدم `minReadySeconds` للاستقرار، وتعامل مع `ProgressDeadlineExceeded` خارج Deployment Controller. احمِ تفاصيل الصحة، وتدرّب على فشل الاعتماديات والضغط، وتحقق من السلوك كما يراه Client. إذا لم تستطع Endpoint تفسير سبب فعل Kubernetes التالي، فعقد Probe غير جاهز.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
- Kubernetes — Configure liveness, readiness and startup probes, verified 15 October 2026
- Kubernetes — Pod lifecycle, readiness and custom readiness gates, verified 15 October 2026
- Kubernetes — Deployment progress deadlines and minimum ready time, verified 15 October 2026
- Kubernetes — Pod v1 API and Probe field defaults, verified 15 October 2026
- Kubernetes — Resource management for Pods and containers, verified 15 October 2026
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.