يمكن لتقييم AI أن يبدو ناضجًا بينما لا يفيد في قرار منتج. قد تعرض Dashboard أن نموذجًا مرشحًا حقق 0.86 بدل 0.82، لكن الفريق يظل عاجزًا عن الإجابة: هل تُحل تذاكر دعم Checkout أسرع؟ هل يقبل التاجر الإجراء المقترح؟ هل بقي Latency ضمن الحد؟ وهل يمكن التراجع عن التغيير بأمان؟
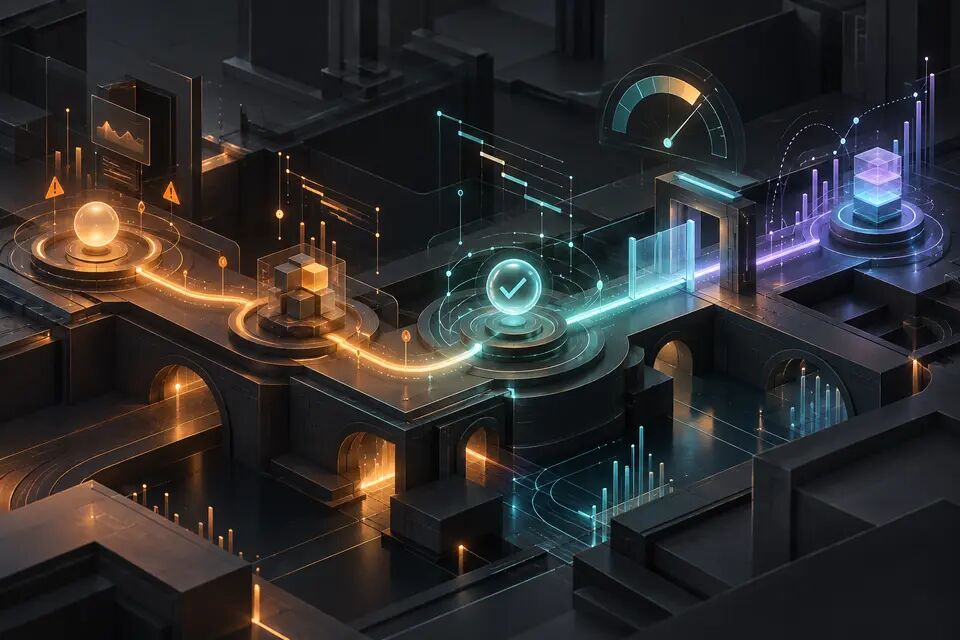
المشكلة الهندسية ليست مجرد تشغيل Grader. المشكلة هي الحفاظ على سلسلة دليل تبدأ بمهمة مستخدم ذات إصدار، ثم نتيجة Offline، ثم إطلاق محكوم، ثم Product Outcome مرصودة. ويجب أن تبقى السلسلة صالحة عند تغيير النموذج أو تعديل Prompt أو تبديل Retrieval، وحتى عند إيقاف خدمة التقييم نفسها.
أصبح هذا مهمًا الآن لأن جدول الإهمال الرسمي من OpenAI يقول إن منصة Evals أُهملت في 3 يونيو 2026، وإن التقييمات الحالية تصبح للقراءة فقط في 31 أكتوبر 2026، وإن Dashboard وAPI مقرر أن تتوقفا في 30 نوفمبر 2026. الدرس ليس «توقف عن التقييم»، بل اجعل عقد التقييم قابلًا للنقل وتعامل مع Dashboard المورد كأداة تشغيل لا كنظام الحقيقة.
ابدأ بقرار المنتج
اكتب القرار قبل اختيار المقياس. يمكن أن يكون القرار المفيد: «رقِّ مساعد الدعم الجديد إلى 20% من المحادثات المؤهلة إذا لم تتراجع دقة تصنيف سياسة الاسترداد، وبقيت Tool Calls غير الآمنة صفرًا في Release Set، وظل p95 Response Latency دون الحد المتفق عليه، وتحسنت الكلفة لكل محادثة محلولة».
تحتوي هذه الجملة على Candidate وPopulation وQuality Gates وOperational Guardrails وفعل ترقية. أما «ارفع متوسط LLM Score» فلا يحتوي شيئًا منها. توصي إرشادات OpenAI للتقييم بتقييمات خاصة بالمهمة وبيانات ممثلة وContinuous Evaluation ومعايرة بشرية بدل المقاييس العامة أو عبارة «يبدو أفضل». كما تبدأ إرشادات Anthropic بمعايير نجاح محددة وقابلة للقياس ومرتبطة بالغرض، وتوضح أن معظم الحالات تحتاج أبعادًا متعددة مثل دقة المهمة والاتساق والكمون والسعر والخصوصية.
افصل ثلاثة أسئلة: هل يستطيع النظام أداء المهمة على Dataset محكومة؟ هل يستطيع العمل داخل حدود الكمون والكلفة والأمان؟ وهل يحسن نتيجة المستخدم بعد الإطلاق؟ لا تجعل Score واحدة تدّعي الإجابة عنها جميعًا.
عرّف عقد تقييم قابلًا للنقل
احتفظ بمصدر الحقيقة في ملفات أو Records ذات إصدارات يسيطر عليها فريقك. يجب أن يسمّي العقد إصدار Dataset وTask Schema وإعداد Candidate وتعريفات Graders وقواعد التجميع والحدود وGuardrails وDecision Rule. وهوية المرشح أكبر من اسم Model: ضمّن Snapshot أو Alias، وPrompt Hash، وإعداد Retrieval، وإصدار Tool Schema، وسياسة الأمان، وRuntime Parameters المهمة.
يمكن أن يبدو عقد توضيحي هكذا:
{
  "task": "refund-policy-resolution",
  "dataset": "support-cases-2026-09-v3",
  "candidate": {
    "model": "provider/model-snapshot",
    "prompt": "sha256:…",
    "retriever": "kb-42",
    "tools": "support-tools-v7"
  },
  "graders": ["route_exact_match-v2", "citation_rubric-v4"],
  "gates": {
    "critical_tool_errors": 0,
    "route_accuracy_min": 0.94,
    "p95_latency_ms_max": 2500
  },
  "decision": "shadow_then_canary"
}
هذا مثال بنيوي لا Thresholds عالمية. خزّن نتيجة كل حالة والنتيجة المجمعة، لأن المتوسط قد يخفي Failure Class شديدة. أعط كل Run معرّفًا ثابتًا يربط العقد وCode Revision والبيانات والمخرجات ونتائج Graders والبيئة.
ابنِ Dataset من توزيع المهام الحقيقي
Dataset القابلة للنقل هي مجموعة Task Records بمعرّفات ثابتة ومدخلات وخصائص متوقعة وSlice Labels. ضمّن الحركة المعتادة والرحلات مرتفعة القيمة والأعطال النادرة والمدخلات الغامضة والحالات العدائية. توصي OpenAI بمزج بيانات المجال والتاريخ والإنتاج والبيانات الاصطناعية والمنسقة بشريًا، ثم توسيع المجموعة باستمرار من الأعطال الجديدة. وتشدد Anthropic على محاكاة توزيع المهمة الحقيقي وإضافة Edge Cases.
لا تنسخ Production Logs إلى مخزن التقييم بلا Data Contract. أزل البيانات الشخصية أو Tokenize لها، وحدد Retention وحدود الموافقة والوصول، وأبقِ Payloads الحساسة خارج Metric Labels. خزّن سياقًا يكفي لإعادة إنتاج المهمة، لكن لا تحتفظ بمحادثة كاملة عندما تكفي مقتطفات صغيرة وحقائق منظمة.
استخدم Release Sets ثابتة للمقارنة، وDiscovery Set متغيرة لاكتشاف أعطال جديدة. إذا دخلت كل حالة إنتاج فاشلة فورًا في Release Set، قد يفرط الفريق في تكييف Prompt مع الحوادث الأخيرة. احتفظ بـHeld-out Set لا يراه مؤلفو Candidate، وأخرج دوريًا الحالات التي لم تعد تمثل المنتج.
استخدم سلّم Grading لا حكمًا واحدًا
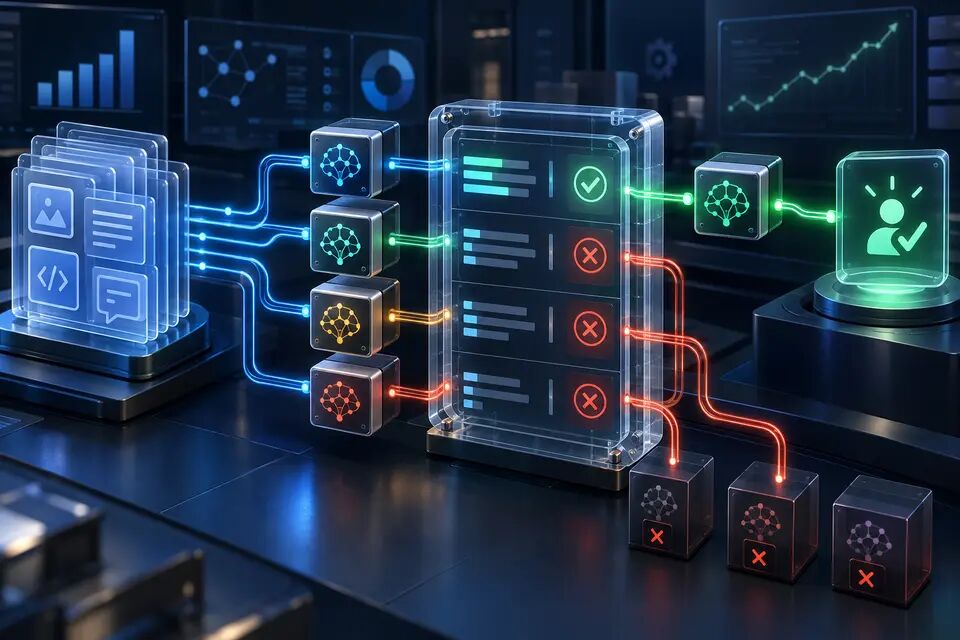
استخدم أرخص Grader موثوق لكل خاصية. ابدأ بالكود: صحة Schema وExact Labels والمراجع المطلوبة وTool Arguments والحسابات والكود القابل للتنفيذ أو Database Assertions. انتقل إلى Pairwise أو Rubric-based Model Grading عندما تكون الخاصية دلالية. واستعن بخبراء المجال للمعايرة والحالات مرتفعة الخطر والخلافات.
توصي OpenAI وAnthropic بـRubrics واضحة وتفضلان أحكامًا مقيدة مثل Pass/Fail أو Classification أو Pairwise Comparison على التقييم المفتوح الغامض. ترتب إرشادات Anthropic Code-based Grading باعتباره الأسرع والأوثق، وHuman Grading باعتباره مرنًا لكنه مكلف، وLLM Grading باعتباره قابلًا للتوسع فقط بعد اختبار موثوقيته. وتحذر OpenAI من انحيازات Judge وتوصي بالحفاظ على اتفاق مع Human Feedback.
امنح Grader إصدارًا كما تفعل مع Product Code. لا يمكن مقارنة Candidate Score بتشغيل سابق إذا تغيرت Rubric بصمت. سجّل Grader Model وPrompt ومنطق Normalization. وشغّل Calibration Set كلما تغير Judge، وأبلغ عن Agreement بحسب الشرائح المهمة لا كنسبة عالمية واحدة فقط.
اربط نتائج التقييم بـProduct Funnel
الصحة Offline هي الطبقة الأولى فقط. في ميزة اقتراحات AI، سجّل Funnel مثل: مؤهل ← تم توليد الاقتراح ← ظهر للمستخدم ← راجعه ← قبله ← نُفذ الإجراء ← احتُفظ بالنتيجة. الرفض والتعديل وUndo والتصعيد Product Signals، وليست مجرد Model Failures.
قس الكلفة لكل مهمة ناجحة، لا لكل Request فقط. توصي قائمة OpenAI للنشر صراحة بمقارنة نجاح المهمة والكمون واستهلاك Tokens والكلفة لكل مهمة ناجحة عند اختيار النموذج. يمكن لنموذج أرخص أن يسبب Retry أو Human Correction أكثر، فيصبح أغلى لكل نتيجة محلولة.
عرّف Outcome Windows. لا يثبت قبول الاقتراح خلال خمس ثوانٍ أنه مفيد إذا تراجع المستخدم عنه بعد ساعة. وقد تحصل إجابة دعم على Thumbs-up لكنها لا تحل الحالة. اربط Interaction Events الفورية بتغيير الحالة اللاحق الذي يمثل قيمة، مع احترام الخصوصية وتقليل البيانات.
أنشئ Trace واحدة من التقييم إلى الإنتاج
استخدم Eval Run ID وCase ID وCandidate Version ثابتة عبر Logs وTraces وResult Records. في الإنتاج، أنشئ Decision ID يربط Model Execution بفعل المنتج من دون وضع نص المستخدم الخام داخل Attributes. سجّل Latency وفئات Tokens ومعرّفات نتائج Retrieval ونتيجة Tool Call وقرارات Grader أو Policy وحالة المنتج النهائية كحقول مضبوطة.
توفر Semantic Conventions في OpenTelemetry أسماء موحدة عبر Traces وMetrics وLogs وProfiles وResources. استخدم Standard Attributes المناسبة، ثم أضف حقول منتج منخفضة Cardinality مثل Feature Version وExperiment Cohort وOutcome Class. لا تستخدم Customer IDs أو Prompts أو Model Output الحرة كـMetric Labels.
افصل Observability Evidence عن Eval Truth. تشرح Trace ما حدث في تنفيذ واحد. ويشرح Eval Store هل حقق التنفيذ معيارًا ذا إصدار. الربط بينهما مفيد؛ دمجهما في Unstructured Log واحدة ليس مفيدًا.
أطلق عبر Shadow وCanary
شغّل Candidate Offline أولًا. إذا اجتاز، استخدم Shadow Traffic يستقبل فيها المرشح مدخلات ممثلة لكنه لا يؤثر في المستخدم ولا يستطيع استدعاء أدوات تغير البيانات. قارن قراراته بالنسخة النشطة، وافحص الخلافات، وتحقق من Latency والكلفة الحقيقيين.
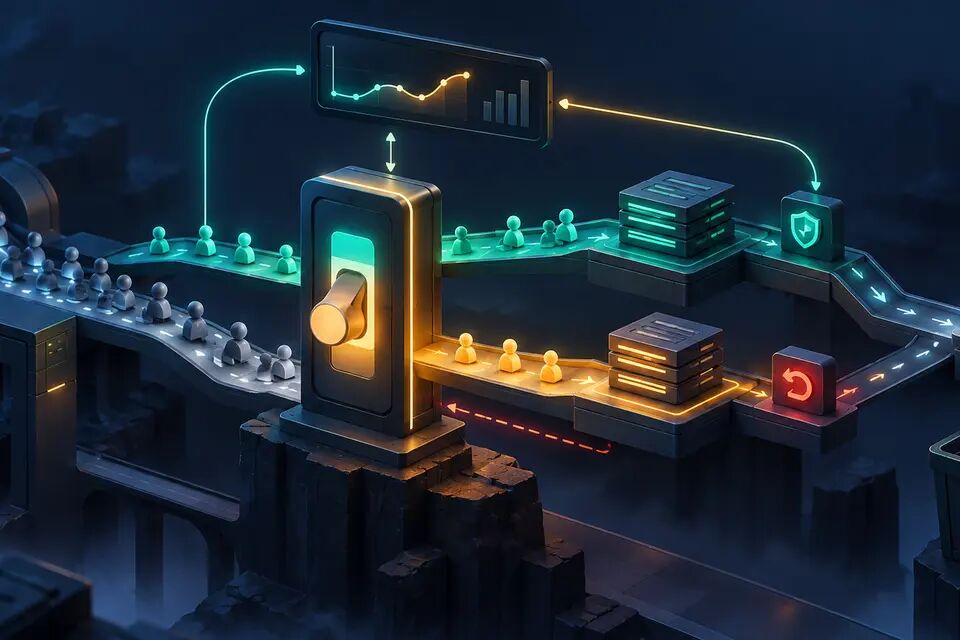
بعد ذلك اكشفه لشريحة صغيرة مؤهلة عبر Routing Rule قابلة للتراجع. أبقِ القيود مرتفعة الخطر خارج Randomization: يحتاج Candidate يستطيع إصدار Refund أو نشر محتوى أو تغيير بيانات عميل إلى Tool Permissions وحدود Approval صريحة. يجب أن تقرأ عملية الترقية Gates العقد تلقائيًا، لكن اجتياز Gate دليل لقرار وليس إلزامًا بالنشر.
يجب أن يعيد Rollback إعداد Candidate السابق كاملًا: Model وPrompt وRetrieval Index وTools وPolicies. التراجع عن Model فقط مع إبقاء Tool Schema أو Prompt الجديدة ينتج Configuration لم تُقيّم قط. احتفظ بالحزمة السابقة قابلة للنشر حتى تغلق Outcome Window.
انقل نظام الحقيقة قبل اختفاء أداة التشغيل
للفرق التي تستخدم OpenAI Evals، الجدول واضح: احصر التعريفات والنتائج الآن؛ وتوقف عن إنشاء اعتماد جديد على حالة لا توجد إلا في Dashboard؛ وصدّر Datasets وRubrics ودليل Runs قبل تاريخ القراءة فقط في 31 أكتوبر؛ واختبر Runner البديلة قبل توقف 30 نوفمبر. تربط OpenAI مسار انتقال إلى Promptfoo، لكن القرار الدائم أوسع من اختيار هذه الأداة بعينها.
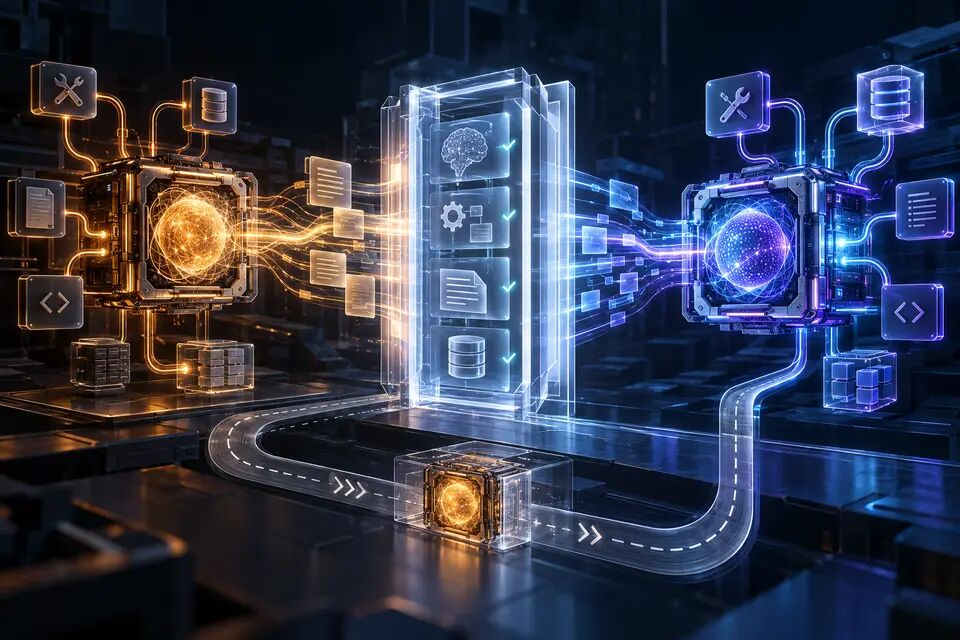
ابنِ Adapter حول Runner. يستقبل عقدك والحالات، ويستدعي النموذج أو Workflow المختار، ويحوّل المخرجات إلى Result Schema الخاصة بك، ثم يعيد الدليل. يمكن لـLocal Harness أو CI Job أو خدمة مستضافة أخرى تنفيذ الحد نفسه. احتفظ بالحدود وقرارات النشر داخل Repository أو Product Control Service بدل إعادة كتابتها يدويًا في كل Dashboard.
لا تنقل Aggregates فقط. احتفظ بمخرجات كل حالة وإصدارات Graders وAnnotations وRun Metadata حتى تبقى الانحدارات قابلة للتفسير. تحقق من التكافؤ بتشغيل Runner القديمة والجديدة على Candidate وDataset ثابتتين، ثم افحص الخلافات قبل تحويل Release Gate.
مثال افتراضي: اقتراح إجراءات للتاجر
تخيل مساعدًا يقترح ردًا وإجراءً اختياريًا لتذكرة دعم تاجر. هذا مثال افتراضي. تحتوي Offline Set على الأسئلة المعتادة، وصيغ عربية وإنجليزية، ومعرّفات طلب مفقودة، ونصوص سياسة متعارضة، وطلبات Refund، ومحاولات ضارة لتشغيل فعل غير مخول.
تتحقق Code Graders من Response Schema ومعرّفات المصادر وTool Arguments. ويتحقق Rubric Grader من استخدام الرد للسياسة المتاحة وطلبه المعلومات الناقصة بدل اختلاقها. وتحتاج الحالات الحرجة إلى Expected Action راجعها إنسان. تمنع Release Gate أي Mutating Call غير مخولة وتطلب دقة توجيه دنيا، بينما يبقى Latency والكلفة Guardrails.
في Shadow Mode لا يستطيع Candidate تنفيذ شيء. وفي Canary Mode تظهر اقتراحات الرد منخفضة المخاطر لشريحة تجار صغيرة، لكن Refunds تبقى بحاجة إلى موافقة صريحة. تميز Product Telemetry بين ظهر وقُبل بلا تعديل وعُدّل ورُفض ونُفذ وفشل وتراجع عنه. لا يرقّي الفريق Candidate إلا عندما يجتاز Offline Gates ويحسن Downstream Outcome مثل زمن حل التذكرة بصورة صحيحة من دون زيادة التراجع أو تصعيد الدعم.
انشر الدليل لا الـScore
يجب أن يحمل تغيير AI الجاهز للإنتاج Evidence Bundle: بيان القرار وإصدار العقد وحزمة Candidate وDataset وSlice Report ومعايرة Grader وتوزيع Latency والكلفة ومراجعة الحالات الشديدة ومقارنة Shadow ونتائج Canary ومرجع Rollback.
مبدأ هندسة المنتجات العملي هو: Eval ليست رقمًا في Dashboard، بل حجة قابلة للتكرار لتغيير تعرض المستخدمين. امتلك العقد، واجعل Runners قابلة للاستبدال، واربط الجودة التقنية بنتائج المنتج، واحتفظ بدليل يفسر الترقية والتراجع معًا.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
- OpenAI — API deprecations: Evals platform timeline, verified 30 September 2026
- OpenAI — Evaluation best practices, verified 30 September 2026
- OpenAI — API deployment checklist, verified 30 September 2026
- Anthropic — Define success criteria and build evaluations, verified 30 September 2026
- OpenTelemetry — Semantic conventions, verified 30 September 2026
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.