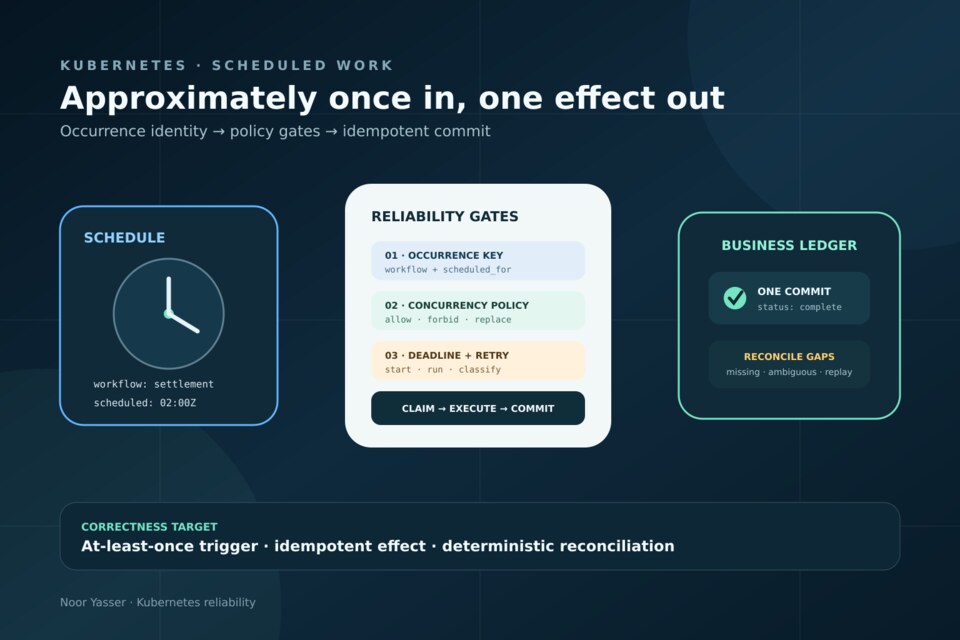
إن Kubernetes CronJob الموثوق لا يضمن أن الأثر التجاري يحدث مرة واحدة بالضبط. توضح وثائق Kubernetes أن CronJob ينشئ Jobs مرة تقريبية عند كل موعد، وأنه قد ينشئ مهمتين أو لا ينشئ مهمة في بعض الظروف. لذلك تأتي صحة الإنتاج من عقد متعدد الطبقات: هوية ثابتة لكل تشغيل مجدول، وآثار جانبية Idempotent، وسياسة تزامن واضحة، وحد أقصى لتأخر البداية ومدة التنفيذ، وتصنيف للأخطاء القابلة لإعادة المحاولة، ومراقبة تقارن التشغيل المتوقع بالمكتمل، ومصالحة تعتمد على مصدر حقيقة خارجي. يفيد ذلك في الفوترة والتقارير والتجديدات ومزامنة المخزون والنسخ الاحتياطي والإشعارات حيث يكون للتكرار أو الفقد تكلفة فعلية.
تذكر وثائق Kubernetes CronJob الرسمية القيد الأساسي بوضوح: إنشاء Job تقريبي، والتكرار ممكن، وعدم الإنشاء ممكن، ولذلك يجب أن تكون Jobs قابلة للتكرار بأمان. هذه حقيقة موثقة عن المنصة. أما أنماط قاعدة البيانات وحدود الخدمات ونموذج التنبيه أدناه فهي إرشادات هندسية لتحويل سلوك المجدول إلى Workflow يعتمد عليه.
تعامل مع CronJob كمحفز لا كمصدر حقيقة
يجيب CronJob عن الوقت الذي يجب أن يحاول فيه Kubernetes إنشاء Job. لكنه لا يعرف هل صدرت الفاتورة فعلًا، أو تزامن الطلب، أو وصل الإشعار. مكان هذه الحقائق هو قاعدة بيانات التطبيق أو نظام موثوق آخر. دع المجدول يقترح Occurrence، ودع التطبيق يحدد هل الأثر جديد، أم مكتمل سابقًا، أم محجوز حاليًا، أم فشل وقابل للإعادة، أم مرفوض نهائيًا.
أقل سجل دائم مطلوب هو Occurrence Ledger. يجب أن تجمع هويته اسم Workflow والوقت المنطقي للجدولة، لا اسم Pod أو Job UID. يجعل Unique Constraint على workflow_key وscheduled_for المهام المتنافسة تتقارب على الصف نفسه. خزّن الحالة وعدد المحاولات ومالك Lease وانتهاءه وإصدار الإدخال ومرجع المخرج وآخر خطأ ووقت البدء والإكمال. إذا خسر Worker سباق الإدخال، يقرأ الحالة الحالية ويخرج أو يساعد في الاستئناف وفق السياسة.
ابتداءً من Kubernetes v1.32 تضيف CronJobs إلى Jobs annotation باسم batch.kubernetes.io/cronjob-scheduled-timestamp بصيغة RFC3339. استخدمه وقتًا للتشغيل عند توفره. وللتوافق أو إعادة التشغيل اليدوية، مرر قيمة Occurrence صريحة إلى Job وتحقق منها. لا تستخرج الهوية من وقت بدء Pod؛ لأن Pod المتأخر أو المعاد سيصبح تشغيلًا تجاريًا مختلفًا.
حدّد معنى الحماية من التكرار
Idempotency ليست مجرد “افحص ثم اكتب”، لأن Workerين قد يفحصان قبل أن يكتب أي منهما. ضع الحارس وتغيير الحالة في Atomic Boundary واحدة. عند تعديل قاعدة البيانات، احجز Occurrence بإدخال فريد أو Compare-and-swap، وعدّل صفوف العمل داخل Transaction، وسجل Outbox Event في Transaction نفسها. يستطيع Dispatcher منفصل إرسال البريد أو Webhook أو رسالة Broker باستخدام Delivery Key خاص به.
تحتاج الخدمات الخارجية إلى حد Idempotency مستقل. إذا كانت واجهة الدفع أو البريد تقبل Idempotency Key، فاشتقه من Occurrence والكيان التجاري واحفظ رد المزود. وإذا لم تقبله، فاكتب Intent دائمًا قبل الاستدعاء وسجل Remote Reference فورًا بعده، وصالح Timeouts الغامضة بدل إعادة المحاولة العمياء. Network Timeout يعني أن النتيجة مجهولة، لا أن شيئًا لم يحدث.
بعض العمل قابل للتكرار طبيعيًا، مثل إعادة بناء Cache من مدخل ثابت أو استبدال Object في مفتاح حتمي. وبعضه ليس كذلك، مثل خصم بطاقة أو زيادة رصيد أو إضافة Ledger Entry أو إرسال رسالة ظاهرة للمستخدم. صنّف كل خطوة واعزل الآثار غير القابلة للعكس خلف أقوى حماية متاحة.
اختر concurrencyPolicy من معنى العمل
يدعم CronJob القيم Allow وForbid وReplace. وتوثق Kubernetes أن Allow هي الافتراضية. تسمح Allow بتداخل الجداول وتناسب فقط التشغيلات المستقلة عندما توجد حماية للسعة في طبقة أخرى. ولا تلغي Idempotency، لأن Jobين لتشغيل واحد قد يظهران رغم ذلك.
تتخطى Forbid التشغيل الجديد ما دامت Job السابقة التابعة لـCronJob نفسها تعمل. تناسب Workflow لا يجوز أن يتداخل، مثل إعادة بناء Snapshot مشتركة، لكنها قد تحول البطء إلى تشغيلات مفقودة بصمت. تعد Kubernetes التشغيل المحجوب بـForbid موعدًا فائتًا. راقب مدة التنفيذ مقابل Interval وحدد هل يجب مصالحة نافذة العمل المتخطاة.
توقف Replace الـJob الحالية عند حلول الموعد الجديد وتبدأ واحدة جديدة. استخدمها فقط عندما لا قيمة للعمل القديم ويمكن للتطبيق تحمل القطع، مثل تحديث Projection مؤقتة. تكون خطرة على Workflow متعدد الخطوات قد يترك آثارًا خارجية جزئية إلا إذا كانت كل خطوة قابلة للاستئناف والتعويض.
تسري Concurrency Policy على Jobs التي أنشأها CronJob واحد فقط. توضح الوثائق أن CronJobs المنفصلة يمكنها العمل معًا. إذا كان جدولان يلمسان الحساب أو صف المخزون أو ملف التصدير نفسه، فافرض العزل أو التسلسل داخل التطبيق بدل افتراض أن Kubernetes سينسقهما.
افصل تأخر البداية عن مدة التنفيذ
يحل startingDeadlineSeconds وactiveDeadlineSeconds مشكلتين مختلفتين. تحد مهلة البداية على CronJob مقدار التأخر المقبول لإنشاء Job بعد موعدها. إذا تجاوزته، تتخطى Kubernetes ذلك التشغيل وتستمر المواعيد المستقبلية. أما activeDeadlineSeconds على Job فتحد إجمالي مدة Job عبر محاولات Pods. عند انتهائها توقف Pods الجارية وتفشل Job بسبب DeadlineExceeded.
استخرج مهلة البداية من Freshness العمل. قد يبقى استيراد سعر الصرف الصباحي مفيدًا بعد تأخير 20 دقيقة، بينما لا يفيد تشغيل مصالحة كل دقيقة بعد ساعات. لا تجعل القيمة أقل من عشر ثوانٍ؛ فـCronJob Controller يفحص كل عشر ثوانٍ وتحذر Kubernetes من أن المهمة قد لا تُجدول. والمهلة الكبيرة جدًا أو الغائبة قد تنتج Catch-up غير مرغوب بعد عطل.
اضبط activeDeadlineSeconds وفق أطول مدة مقبولة، بما يشمل Backoff والتعافي، لا متوسط P50. تنص Kubernetes على أن Active Deadline تسبق backoffLimit. يجب أن تترك المهلة وقتًا للـWorker كي يتوقف بأمان ويحرر Leases ويسجل النتيجة قبل إنهاء Pod.
تكوّن المهلات عقد خدمة: ابدأ قبل انتهاء Freshness Budget، وانتهِ قبل Processing Budget. ويجب أن يدخل فشل المهلة في المصالحة لا أن يختفي كخطأ Pod عام.
اجعل الجدول والمنطقة الزمنية صريحين
عيّن spec.timeZone بدل الاعتماد على المنطقة المحلية لـkube-controller-manager. توثق Kubernetes أن timeZone مستقرة منذ v1.27 وترفض CRON_TZ أو TZ داخل schedule. استخدم Etc/UTC عندما يكون Workflow عالميًا أو قائمًا على Interval. واستخدم IANA Business Zone فقط عندما يكون الوعد محليًا فعلًا، مثل “09:00 بتوقيت القاهرة”.
قد تجعل انتقالات التوقيت الصيفي بعض الأوقات المحلية مكررة أو غير موجودة. حدد قاعدة المنتج: تشغيل واحد عند أقرب وقت صالح، أم تخطٍّ، أم اعتبار Offsetين تشغيلين منفصلين. يجب أن يخزن Ledger وقتًا مطلقًا، ومعه التاريخ المحلي والمنطقة عند الحاجة. لا تدع Timezone داخل Container Image تعيد تفسير جدول Controller بصمت.
يؤثر تعديل CronJob على Jobs المستقبلية فقط؛ وتستمر Jobs وPods القائمة بالقالب القديم. أثناء Rollout خزّن Configuration Version في Ledger والسجلات حتى يميز المشغل بين السلوك القديم والجديد.
صنّف إعادة المحاولة بدل إعادة كل شيء
تقول وثائق Kubernetes Job إن backoffLimit افتراضيًا ست محاولات وإن Pods الفاشلة تعاد بتأخير أسي يصل سقفه إلى ست دقائق. تفيد الإعادة عند فشل شبكة مؤقت أو إخلاء عقدة، لكنها تهدر الوقت وقد تكرر الضرر مع Credential خاطئة أو Input مشوه أو قاعدة عمل مكسورة.
استخدم podFailurePolicy لتصنيف Exit Codes وPod Conditions المعروفة. يعرض دليل سياسة الفشل الرسمي إجراءات مثل FailJob لكود تطبيقي نهائي، وIgnore لتعطّل لا يجب أن يستهلك ميزانية الإعادة، وCount للفشل العادي. صمّم Entry Point ليصدر Exit Codes مقصودة وأسبابًا منظمة. تجنب Shell Wrapper يحول كل فشل إلى Code 1 ويهدم التصنيف.
استخدم restartPolicy بقيمة Never عندما تريد كل محاولة في Pod منفصل بسجلات محفوظة. أما OnFailure فقد يعيد Container داخل Pod نفسها ويعقّد حساب المحاولات. وفي الحالتين يجب أن تصمد Idempotency أمام توقف العملية بين الأثر الخارجي وتسجيل النجاح محليًا.
معمارية إنتاجية
تقيّم Control Plane الجدول والمنطقة والتعليق ومهلة البداية وسياسة التزامن ثم تنشئ Job. تقرأ Pod قيمة Scheduled Occurrence، وتتصل بـCoordinator لحجز Ledger Row، وتنفذ خطوات محدودة، وتثبت الحالة مع Outbox Records، ثم تضع التشغيل مكتملًا. يرسل Dispatcher الأحداث الخارجية. ويقارن Reconciler منفصل نوافذ العمل المطلوبة بصفوف Ledger المكتملة وينشئ Replay Requests صريحة للعمل المفقود أو الغامض.
في تسوية يومية عند 02:00 UTC، قد تستخدم مواصفة عملية timeZone بقيمة Etc/UTC وconcurrencyPolicy بقيمة Forbid وStart Deadline قدرها 1,800 ثانية وActive Deadline قدرها 2,400 ثانية وbackoffLimit بقيمة 3 وTTL يكفي للتحقيق. هذه قيم توضيحية وليست قاعدة عامة. استخرجها من Freshness وأسوأ مدة وحدود المزود وحاجة Incident Response.
لا تجعل Pod تمسح Dataset بلا حد. قسم العمل إلى صفحات أو كيانات حتمية، واحفظ Checkpoints، واجعل كل عنصر Idempotent مستقلًا. إذا تجاوز الحجم Interval واحدًا، فلتضع CronJob مهامًا محدودة في Durable Queue ثم تخرج بدل تداخل Monolith يتضخم.
راقب المتوقع والمنشأ والمبدوء والمكتمل
عدد Pods الخضراء ليس Business SLO. تتبع أربعة أوقات: الموعد المتوقع، وإنشاء Job، وبدء أول Worker، واكتمال العمل التجاري. استخرج منها Schedule Lag وScheduling Lag وExecution Duration وEnd-to-end Freshness. صنف Metrics حسب Workflow والنتيجة، لكن تجنب Occurrence IDs عالية Cardinality في Labels؛ ضعها في Logs وTraces.
نبّه عندما لا يوجد تشغيل ناجح ضمن نافذة Freshness، أو ترتفع تعارضات الحجز المكرر، أو تسبب Forbid مواعيد متخطاة، أو تقترب المدة من Interval، أو تعمل Active Deadlines، أو تتكرر أخطاء نهائية، أو يجد Reconciler فجوات. تفيد سجلات Controller عن “too many missed start times”، لكن Business Reconciliation أقوى لأنها تسأل هل العمل المطلوب موجود، لا هل أنشأ Controller كائنًا.
في الإصدارات التي توفر Scheduled Timestamp Annotation، سجله مع Job UID وOccurrence Key. اربط Pod Logs وTraces وDatabase Ledger ومرجع المزود. يجب أن يستطيع المشغل الإجابة: ما نافذة العمل المطلوبة؟ أي كود وإعداد عمل؟ ما الآثار المثبتة؟ وهل Replay آمن؟
الاحتفاظ والتنظيف
تحدد History Limits عدد Jobs الناجحة والفاشلة التي تبقى مرتبطة بالجدول. ويستطيع TTL-after-finished Controller حذف Job مكتملة أو فاشلة بعد spec.ttlSecondsAfterFinished مع العناصر التابعة. تذكر Kubernetes أن العداد يبدأ عند وصول Job إلى Complete أو Failed وأن Clock Skew قد يؤثر على توقيت التنظيف.
تنظيف كائنات Kubernetes ليس Audit Retention. صدّر السجلات واحتفظ بـOccurrence Ledger حسب احتياجات العمل والامتثال قبل حذف Jobs وPods. احتفظ بالفشل مدة أطول إن ساعد التحقيق، لكن لا تترك كائنات غير محدودة في API Server. وتحقق أن Logging Pipeline تفرغ البيانات قبل إزالة Pod.
دليل القرار
استخدم Allow عندما تكون التشغيلات مستقلة والتداخل مقبولًا وتوجد Application Admission تحمي الاعتمادات. استخدم Forbid عندما يسمح بتنفيذ واحد فقط وتُكتشف الجداول المتخطاة وتُصالح. استخدم Replace عندما يهم أحدث Refresh فقط ولا يؤدي الإلغاء إلى إفساد حالة خارجية. واستخدم Durable Queue أو Workflow Engine بدل CronJob عندما يحتاج العمل إعادة لكل عنصر أو Orchestration طويلة أو موافقة بشرية أو تشغيلًا Event-driven أو ضمانات تسليم قوية عبر خطوات كثيرة.
استخدم Kubernetes Job مباشرة لمهمة واحدة محدودة. واستخدم Managed Scheduler خارجيًا إذا كان Trigger يجب أن يصمد أمام فقدان Cluster أو ينسق Clusters عدة. واستخدم Database Scheduler فقط عندما تكون ملكية قاعدة البيانات والحمل مقصودين. CronJob محفز Cluster-native ممتاز، لكنه ليس تلقائيًا أفضل مالك للتقويم التجاري.
أفضل الممارسات والأنماط الخاطئة
ثبّت Image Digest صريحًا، وشغّل بـServiceAccount قليلة الصلاحيات، واضبط Resource Requests وLimits، واجعل Shutdown Handler يسجل حالة قابلة للاستئناف، وتحقق من Occurrence قبل العمل. اختبر Job مكررة، وبداية متأخرة، وتوقف Controller، وإخلاء Pod، وProvider Timeout بعد نجاح، وفقد اتصال قاعدة البيانات بعد Commit، وانتقال توقيت صيفي، وReplay يدوي.
تجنب استخدام Pod Name كمفتاح Idempotency، واعتبار Forbid حماية من التكرار، وترك timeZone ضمنية، واعتبار Timeout فشلًا قبل الأثر، وإعادة كل Exit Code، وحذف Jobs قبل حفظ Logs، أو التنبيه على فشل Pod فقط. ولا تحدث “آخر تشغيل ناجح” قبل Commit المعاملة التجارية.
القيود
تستطيع Kubernetes إنشاء Jobs والإشراف عليها، لكنها لا تستطيع إثبات النجاح الدلالي داخل Payment أو ERP أو Email أو Storage خارجي. تعني Job Complete أن Containers حققت معايير نجاح Job، ولا تعني أن كل سجل مقصود عولج. وبالعكس، قد تكون Pod الفاشلة أكملت أثرًا خارجيًا قبل فقدان الإقرار.
Exactly-once Execution ليس وعدًا واقعيًا من Scheduler في الأنظمة الموزعة. استهدف At-least-once Triggering مع أثر تجاري Exactly-once أو Idempotent، وغموض قابل للمراقبة، ومصالحة حتمية. هذا التصميم يصمد أمام التكرار والفقد معًا.
قائمة تنفيذية
حدد Logical Occurrence Key وUnique Constraint. اختر timeZone وconcurrencyPolicy وStart Deadline وActive Deadline وRetry Policy من معنى العمل. اجعل كل أثر غير قابل للعكس Idempotent أو قابلًا للمصالحة. خزّن Ledger وإصدار الإعداد. راقب Freshness من المتوقع إلى المكتمل لا Pods فقط. احتفظ بالدليل قبل TTL Cleanup. اختبر التكرار والفقد والتأخير والقطع وTimeout الغامض. إذا لم يمكن Replay للـWorkflow بأمان فهو غير جاهز لـCronJob إنتاجي.
المراجع الرسمية
تدعم هذه المراجع سلوك الأدوات المذكورة. الأمثلة وقرارات التصميم توضيحية، ويجب تكييفها مع متطلبات المشروع وإصداراته.
- Kubernetes — CronJob concepts and limitations, verified 14 October 2026
- Kubernetes — Jobs, retries and active deadlines, verified 14 October 2026
- Kubernetes — Running automated tasks with a CronJob, verified 14 October 2026
- Kubernetes — Pod failure policy for retriable and terminal failures, verified 14 October 2026
- Kubernetes — Automatic cleanup for finished Jobs, verified 14 October 2026
- Kubernetes — CronJob v1 API reference, verified 14 October 2026
إعداد: Noor Yasser
تعمل على تحدٍ تقني مشابه؟
أساعد الفرق على تحويل القرار المعماري إلى نطاق واضح وتنفيذ يمكن تشغيله ومراجعته بثقة.